H200 八卡服务器四个月涨了近 40%,报价从 360 万元冲到 500 万元以上;可另一边,部分地方智算中心的 GPU 利用率只有 30%—40%。一边抢卡、一边闲置,国产模型还在地板价卖 Token,中国算力到底缺不缺?
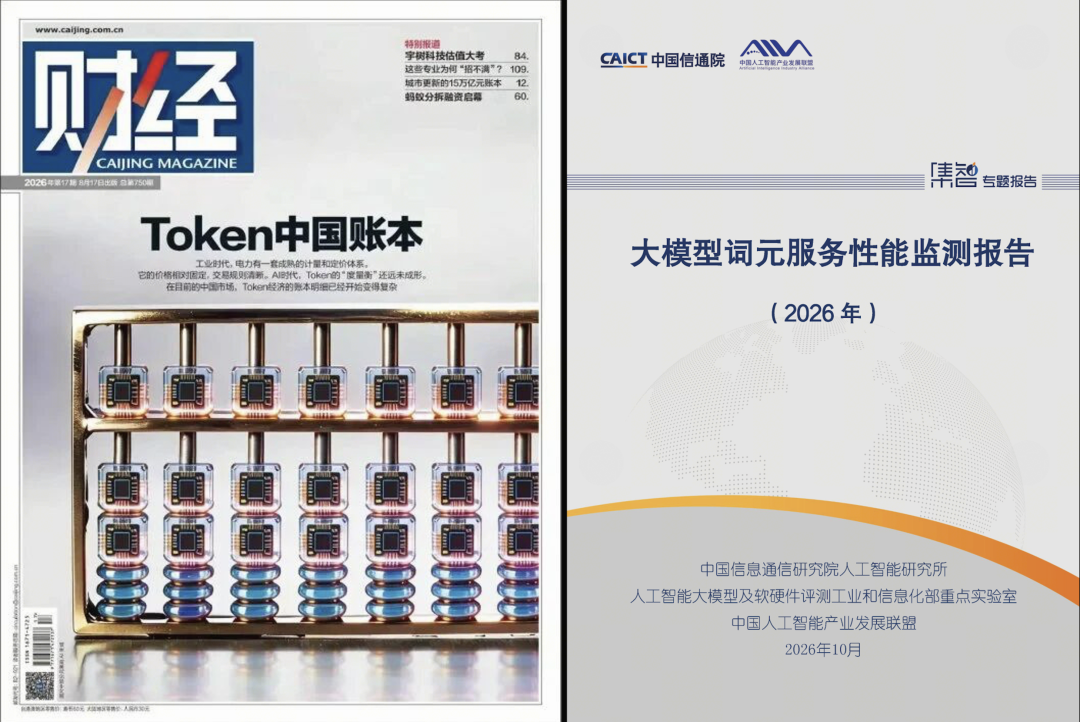
最近看了《财经》8月份的一篇封面报道《Token经济,中国账本》,写的非常好,忍不住和大家分享。
原文链接:https://finance.sina.com.cn/stock/roll/2026-08-17/doc-ininruym7741844.shtml
与此同时,我又查了下,中国信通院10月份也发布了一份《大模型词元服务性能监测报告(2026年)》。
我把这两篇结合在一起,简单和大家分享一下。
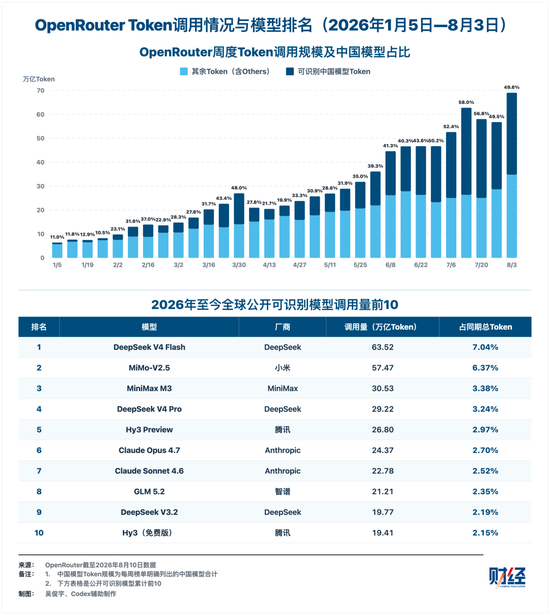
今年前7个月,在美国模型交易平台 OpenRouter 上,中国模型贡献了约 369万亿 Token 调用量,占平台总量的 41%。
中国模型能获得这么多海外开发者的青睐,一个重要原因就是便宜。
另一方面,今年4月,一台英伟达 H200 八卡服务器,在国内渠道的报价大约 360万元。到了8月,已经超过 500万元。
短短四个月,涨了近 40%。
但《财经》调查发现,在这轮 AI 需求爆发之前,国内一些地方智算中心的 GPU 利用率只有 30%—40%,甚至出现了数据中心建好了,却找不到足够客户的情况。
同样一类 GPU 服务器,如果买入价格 360万元、利用率70%,理论上 17.8个月可以回本;但如果 500万元买入、利用率只有 30%,回本周期就会拉长到 65.6个月。
将近五年半,而 GPU 服务器通常按照五年左右的周期折旧。也就是说,按照后一种假设,设备可能已经到了折旧期,投资还没有收回来。
这就有点奇怪了。
一边是 GPU 价格暴涨,大家都在抢算力;另一边,却有花了几个亿建设的数据中心,连设备都没法充分利用。
与此同时,中国的大模型还在全球打价格战,DeepSeek、Qwen、GLM 等国产模型凭借低价吸引海外开发者。
中国 AI 到底是算力不够,还是算力已经建多了?既然 GPU 这么贵,国产模型为什么还能卖得这么便宜?
01 GPU 涨了近 40%,但真正决定赚钱与否的是利用率
先看《财经》那组服务器成本测算。
一台 H200 八卡服务器,4月份的渠道报价约 360万元,8月份超过 500万元。
另一款性能更强的 B300 服务器,同期渠道报价更是从 400万—500万元,涨到了 1300万—1500万元。
对于那些实际以高价采购设备的企业来说,买入成本确实会直接影响投资回报。
而且 GPU 和普通的固定资产不太一样。
比如买一栋写字楼,如果暂时租不出去,虽然需要承担资金和维护成本,但建筑物还在那里,未来仍然可能出租或出售。
GPU 却会面临非常快的技术更新。
今年买的服务器,可能两三年后就出现了性能更强、成本更低的替代产品。
所以一家公司投资 500万元买 GPU,不仅需要找到客户,还必须尽可能快地把钱赚回来。
《财经》根据英伟达公开的技术数据,测算了一台 H200 服务器运行智谱 GLM-5.2 的理论回本周期。
假设采购价 360万元,GPU 利用率 70%,约 17.8个月可以回本。
如果采购价上涨到 500万元,GPU 利用率又只有 30%,回本周期就达到 65.6个月(五年半)。
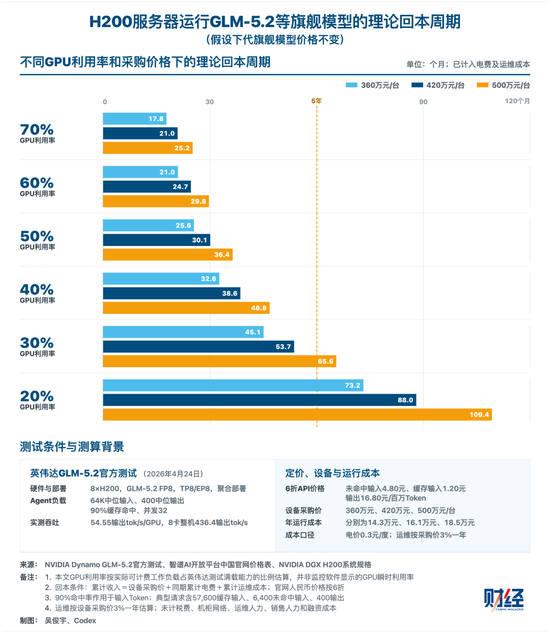
这份测算只考虑了电力和部分运维成本,还没有计入全部人力、网络等费用。
不过它说明了一件事:
GPU 的成本有很大一部分在买入时就确定了,但能够产生多少收入,却取决于后面有没有足够多的人使用。
买得贵,又用不起来,是最糟糕的组合。
这时候再看国内各地建设智算中心的新闻,就会发现,宣布投入多少亿元、买了多少张 GPU,其实只是故事的开始。
真正重要的是,这些机器建成后,有多少时间能够被客户有效使用。
02 全国都缺 GPU,为什么有些地方却卖不出去?
《财经》采访的一位服务器厂商 CEO 提到,过去三年,国内不少地方建设了智算中心。
单个项目投资起步往往超过2亿元,大项目甚至超过10亿元。
但在 2026年这轮 AI 需求爆发之前,部分地方智算中心的利用率不到 50%,一些只有 30%—40%。
有的项目建完之后,甚至还没有找到足够的客户。
为什么会出现这样的情况?
我觉得这里最容易产生一个误解:AI 公司需要算力,不代表任何人购买的 GPU,都能直接变成 AI 公司需要的算力。
举个比较容易理解的例子,假设一家物流公司准备建设大型仓库。
第一家公司已经拿到客户订单,知道客户需要多少面积、什么类型的仓库、什么样的设备,然后按需求建设。
第二家公司则是觉得未来物流市场很大,先投资建设仓库,再去寻找客户。
结果可能完全不同。
如果客户需要的是自动化仓库,而第二家公司建的是普通仓库,即使整个物流市场需求很旺盛,它也未必能找到足够的生意。
算力市场其实有类似的问题。
AI 公司不仅需要 GPU 数量,还对芯片型号、显存、网络速度、系统稳定性等有要求。
一些复杂任务需要大量 GPU 协同工作,也不是把几千张不同型号、分散在不同地方的 GPU 简单加起来就可以了。
更现实的是,客户是否愿意购买、购买多少、能不能长期使用,这些在建设之前就应该想清楚。
大型云厂商和模型公司本身拥有大量用户,能够把持续产生的AI任务分配到自己的服务器上。
而部分地方智算中心可能先完成建设,后面才开始寻找客户。
所以,即使全国的算力需求快速增长,也不能保证每一个智算中心都能获得足够订单。
算力市场可能不是简单的供不应求,而是客户真正需要的算力紧缺,另一些算力却暂时没有找到合适的客户。
这也解释了为什么 GPU 价格高涨和部分数据中心闲置,可以同时发生。
但问题又来了“
如果 GPU 本来就昂贵,使用率又直接影响成本,那么中国模型为什么还能以很低的价格向全球销售 Token?
03 国产模型卖得便宜,不代表算力便宜
今年中国模型出海,有一个很重要的优势就是价格。
《财经》统计了 16款全球主流模型的官方 API 报价,并按照一种典型的 AI 任务使用方式计算综合价格。
结果发现,中国旗舰模型的综合调用价格,大约只有美国旗舰模型的 30%—60%。
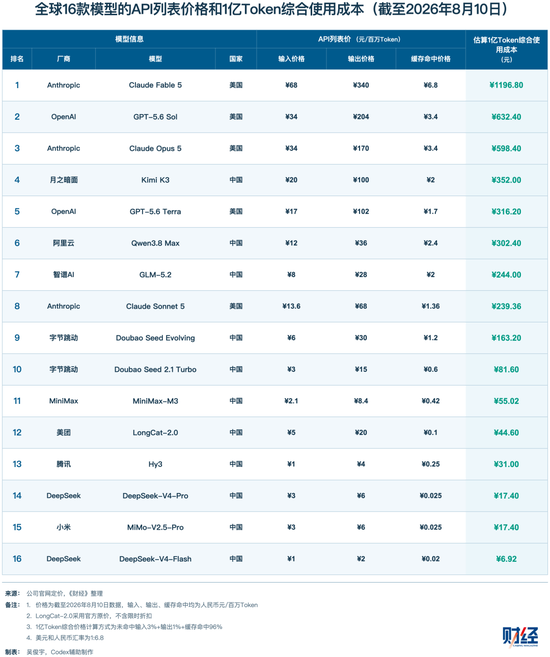
部分国产入门模型,价格甚至不到美国一些中端模型的3%。
中国模型的低价竞争力确实存在。
但前面我们已经看到,中国高端 GPU 的采购成本不一定便宜,甚至可能因为供应限制而承担很高的溢价。
这两件事为什么不矛盾?
首先,模型卖给客户的价格,并不完全等于它实际生产 Token 的成本。
厂商可以选择降低利润、向重要客户提供折扣,甚至为了争夺市场而补贴。
《财经》就采访到,阿里云、腾讯云、火山引擎等云厂商,在销售部分模型服务时,可以向战略客户提供较大的折扣。
其次,中国模型公司也在通过技术优化降低成本。
这里不需要讨论太复杂的算法。
可以简单理解成,同样一台 GPU,如果一家公司的模型需要做十次计算才能完成某项工作,另一家只需要做五次,那么后者就有机会以更低成本提供服务。
另外,AI 执行复杂任务时,经常需要重复读取已经处理过的资料。
如果系统能记住前面处理过的内容,不需要每次重新计算,也能节省大量算力。
《财经》就测算过,在特定的 Agent 任务场景下,DeepSeek-V4-Pro 的综合使用价格,比此前 DeepSeek-R1 低了 86%。
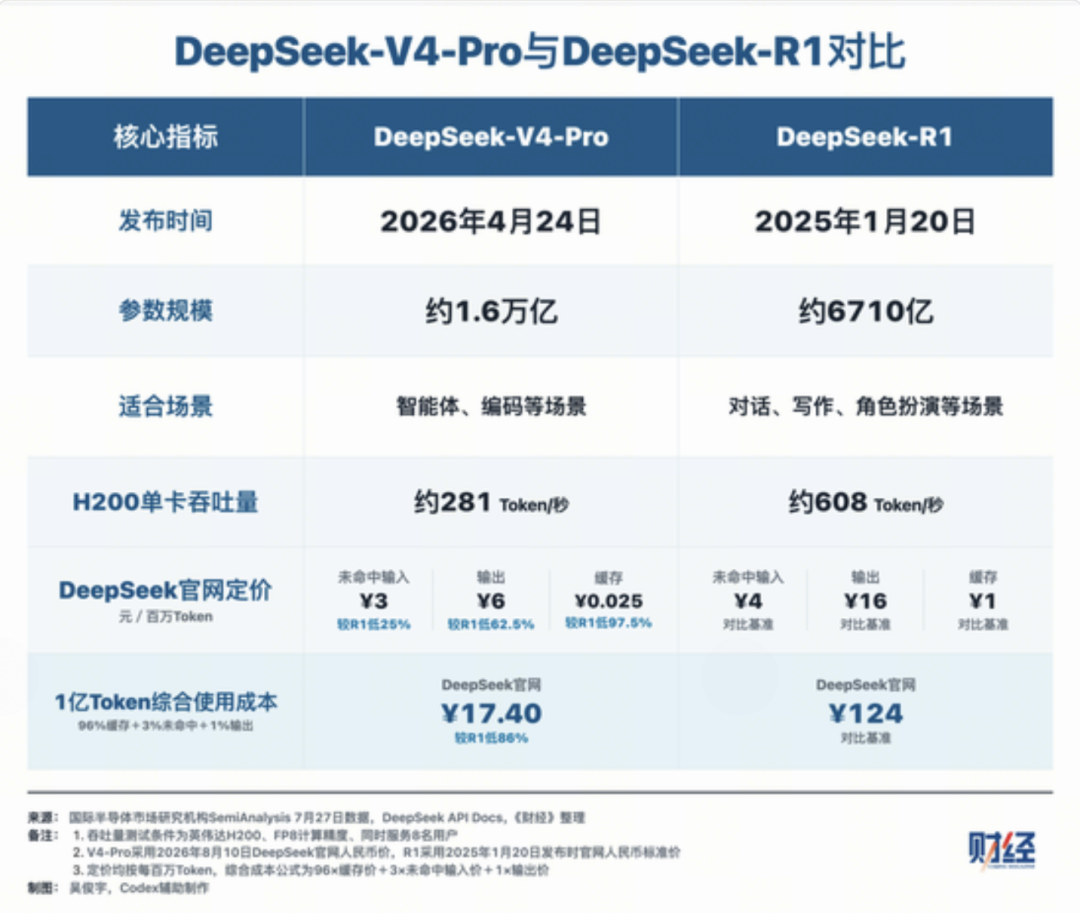
其中一个重要原因,就是重复信息的缓存成本降低了。
中国信通院的报告还发现,即使使用同一个开源模型,放到不同服务平台上运行,输出速度也可能出现明显差异,部分平台之间甚至接近一倍。
这说明,同样的芯片、同样的模型,不同公司最终提供服务的效率也可能不同。
所以,国产模型能卖得便宜,并不一定是因为生产 Token 的所有成本都更低,也可能是技术效率、市场竞争和定价策略共同作用的结果。
但如果厂商为了争夺客户,把价格压得很低,它也需要找到足够大的使用规模,才能把研发、算力和运营成本分摊出去。
这时候,上游 GPU 利用率的问题,又和下游 Token 价格联系起来了。
如果一家公司有大量稳定客户,设备能够持续运转,那么它更有机会降低单位成本。
反过来,如果设备长期闲置,即使采用同样的模型,也很难摊薄此前的投资。
这可能让具备大规模真实需求的企业,在后续竞争中获得更大的优势。
04 美国公司的开发者套餐反而可能更便宜
如果中国模型更便宜,是不是意味着中国开发者使用国产 AI 也一定更省钱?
《财经》发现,答案并不一定。
今年7—8月,研究人员自己购买了国内外主流模型的开发者套餐,反复执行相同的财务数据整理任务,再根据套餐实际可使用的 Token 数量计算价格。
结果如下:
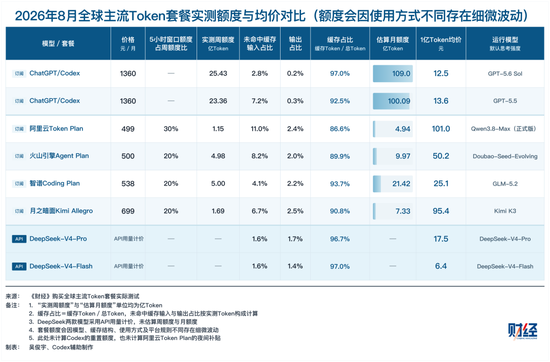
在这组测试中,阿里云套餐的折算价格,是 OpenAI Codex 的约 8倍。
明明国产模型 API 价格普遍更低,为什么开发者订阅反而可能更贵?
答案其实和前面 GPU 的成本问题有关,但还多了一层商业竞争。
OpenAI、Anthropic 等美国头部公司,愿意对重度开发者提供非常激进的套餐价格。
因为它们想争夺的,不只是一个每月支付 200美元的个人用户。
一个程序员今天用什么 AI 开发软件,未来就可能影响一家企业使用什么模型、购买哪家的 API,甚至选择哪一套技术生态。
因此,开发者套餐可以被视为一种获客投资。
《财经》引用 SemiAnalysis 的测试发现,OpenAI 每月 200美元的 Codex 套餐,实际可用额度按 API 列表价折算,价值可达到约 1.4 万美元。
对于中国模型公司来说,情况可能不同。
在高端芯片采购成本、融资条件和商业化压力等因素影响下,它们未必愿意、也未必有能力在所有客户群体上都提供同等力度的补贴。
于是出现了一个很有意思的现象:
中国厂商在企业 API 市场打低价,美国头部公司却在开发者套餐市场打低价。
这不是简单的谁成本更低,而是谁更愿意为哪一类客户投入补贴。
也正因为如此,不能看到某个模型卖得便宜,就直接推断这家公司赚钱更多,或者生产成本一定更低。
低价可能是技术优势,也可能是市场策略,当然还可能是两者共同作用。
05 当 Token 越来越便宜,GPU 投资反而更危险
过去几年,AI 模型价格整体经历了非常明显的下降,市场需求却持续增长。
中国信通院数据显示,今年6月,国内日均 Token 消耗量约 500万亿,是 2025年 12月的近四倍。
需求增长这么快,大家自然愿意投资更多算力。
但需求增长不一定意味着 GPU 投资风险下降,为什么呢?
因为 Token 越便宜,数据中心要想收回相同的设备投资,就可能需要生产和销售更多 Token。
假设一家数据中心原来每生产一定数量 Token,可以获得 100元收入。
后来模型竞争加剧,同样数量 Token 只能卖 50元。
如果其他条件不变,它就需要把销售量提高一倍,才能维持原来的收入。
当然,现实中芯片性能、推理效率、模型结构也在不断改善,单位成本可能同步下降,并不能认为降价一定导致利润变少。
但对于那些已经花高价买入旧设备的公司来说,情况可能比较被动。
因为设备的采购成本已经确定了,而未来市场价格却可能继续变化。
《财经》引用的技术测试还发现,新一代B300在运行特定DeepSeek模型时,单卡 Token 产出能力可以达到 H200 的 5至 28倍,单位 Token 成本可能只有 H200 的 7%—37%。
这里有一点是确定的:新设备可能通过更高的生产效率,改变市场上的成本水平。
于是,先前高价买入旧设备的公司可能面对两种压力。
一方面,过去利用率不够高,投资还没有收回来。
另一方面,新设备不断出现,竞争对手可能用更低的成本提供同类服务。
所以我觉得这才是 GPU 投资中一个容易被忽略的风险。
你买的不只是一台昂贵的服务器,还是一台需要在技术持续更新、市场价格不断变化的环境里,尽快收回成本的机器。
如果设备利用率一直很高,客户持续增加,当然可能是一笔不错的投资。
但如果买得贵、用得少,后来又遇到新设备降价竞争,回本就会越来越困难。
这也是为什么我觉得,仅仅看到 AI 需求每年增长多少倍,还不足以判断一座智算中心是否值得投资。
06 中国 AI 真正出现的,是两种完全不同的算力市场
看完这两份报告,我不认为可以简单地说中国算力已经过剩,或者算力永远不够用。
我更倾向于认为,随着市场发展,算力可能出现越来越明显的分化:
一类算力,拥有合适的芯片、稳定的客户需求和较高的运行效率,能够持续为模型公司或企业提供服务。
另一类算力,虽然已经完成投资建设,但设备与客户需求未必匹配,也没有足够的使用量来摊薄成本。
前者可能仍然供不应求,后者却可能面临闲置。
而且,这种分化未必只发生在地方智算中心和大型云厂商之间。
即使是大型企业,如果高价购买了不适合未来需求的设备,也可能承担投资风险。反过来,一家规模不大的专业算力服务商,如果能找到稳定客户、做好模型适配和运营,也有机会形成竞争力。
但从整个行业看,我认为最需要警惕的是一种思路:
因为 AI 需求增长很快,所以只要先把 GPU 买回来,就一定能赚钱。
《财经》那组 17.8个月和 65.6个月的回本测算,已经说明事情没有这么简单。
尤其对于那些投资几亿元甚至几十亿元的智算中心,利用率和采购价格发生变化,可能直接决定项目最终能否收回投资。
而中国模型公司正在全球用低价争夺客户,也意味着算力服务商不能简单指望 Token 一直维持高价。
如果未来模型调用量继续增长,但单位 Token 的销售价格不断下降,真正有优势的可能是那些拥有稳定客户、能够不断降低生产成本的企业。
至于一些缺少客户、设备又不够先进的数据中心,即使身处一个高速增长的市场,也未必能够获得理想回报。
中国 AI 已经不缺关于模型发布、GPU 采购和 Token 增长的新闻。
但相比这些数字,我现在更想知道的是,一家公司花了多少钱建设算力,最终有多少设备真正投入使用,生产出来的服务又能以什么价格卖出去。
以上,祝你今天开心。
作者:张艾拉 公众号:Fun AI Everyday
本文由 @张艾拉 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议