AMD今日公布了Zen 6微架构的全部细节,并宣布第六代EPYC 9006系列服务器处理器(代号Venice)即日起开售。新品把x86服务器的核心数上限推到了256核,IPC较上代提升约27%,平台也换成全新的SP7与SP8两档。AMD的说法是,这一代就是为Agentic AI时代设计的。
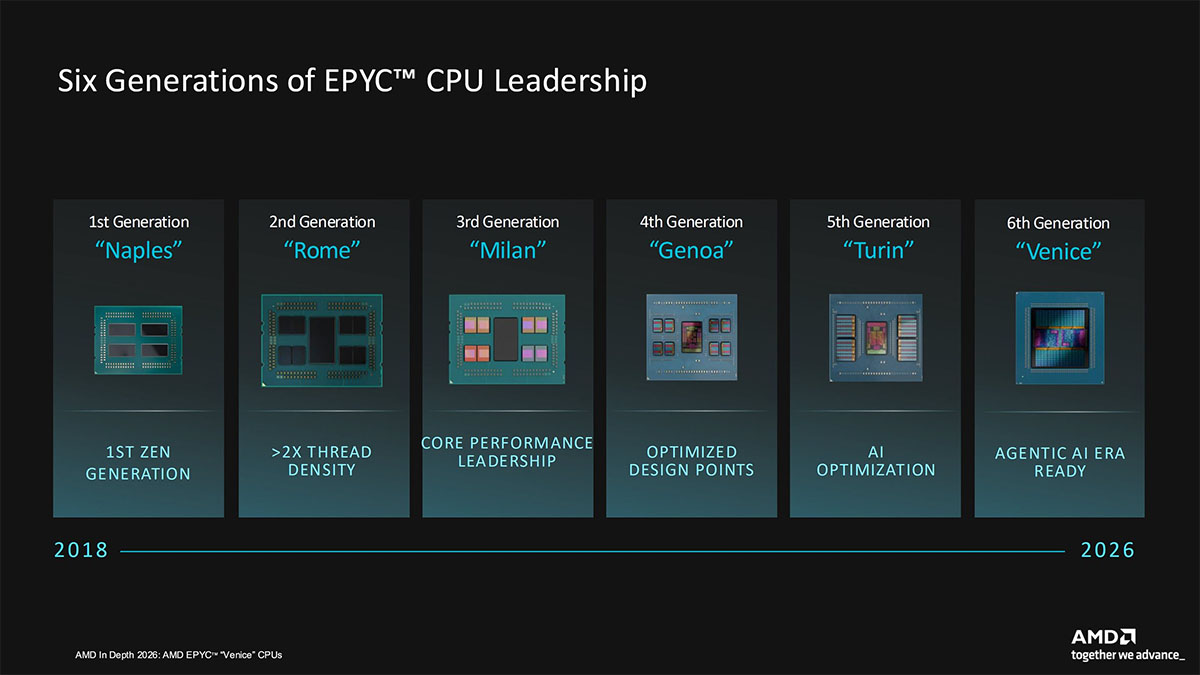
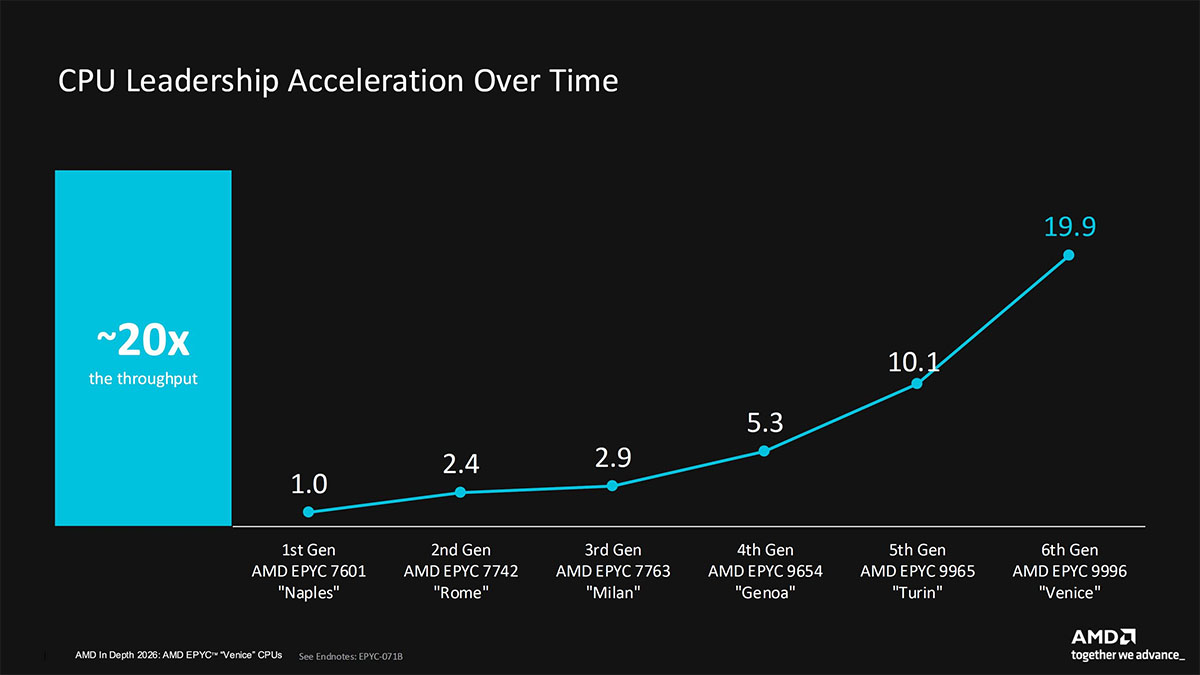
EPYC到今天是第六代。2018年首款产品Naples问世,此后每一代都伴随核心架构、工艺与平台的大换血。AMD自己的走势图里,从初代EPYC 7601的1.0到六代EPYC 9996的19.9,单路吞吐累计提升约20倍,收入份额曲线则从2017年起一路向上。
Zen 6与Zen 6C沿用同一套ISA,分别对应标准核与稠密核,接替Turin(EPYC 9005)上的Zen 5与Zen 5C。分工很明确:Zen 6追求最高频率与单路性能,Zen 6C主打核心密度、能效与低延迟。
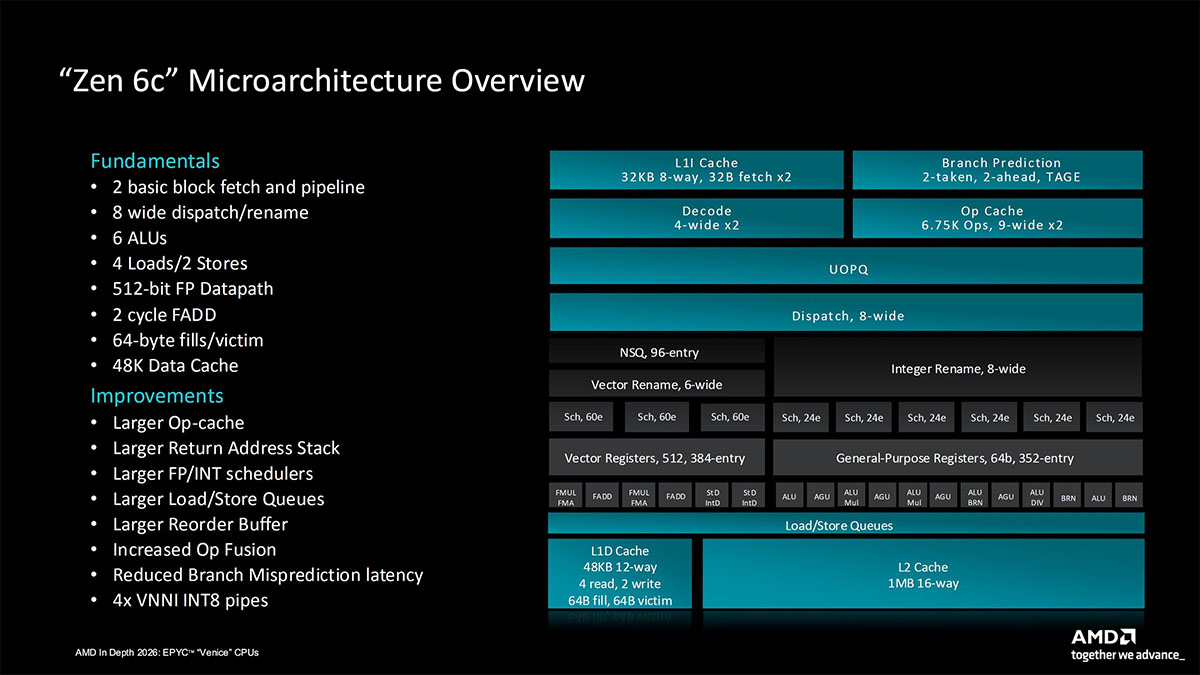
具体到微架构,AMD列出的改进清单有一半都是“加大”:op-cache、返回地址栈、整数与浮点调度器、载入/存储队列、重排序缓冲,清一色扩容。真正新增的东西在AI这边,VNNI-INT8管线从2条翻倍到4条,分支误预测的代价也压低了。这些改动摆在一起,看不出什么取巧的新花样,就是把每个会卡吞吐的队列都往宽里做一遍。
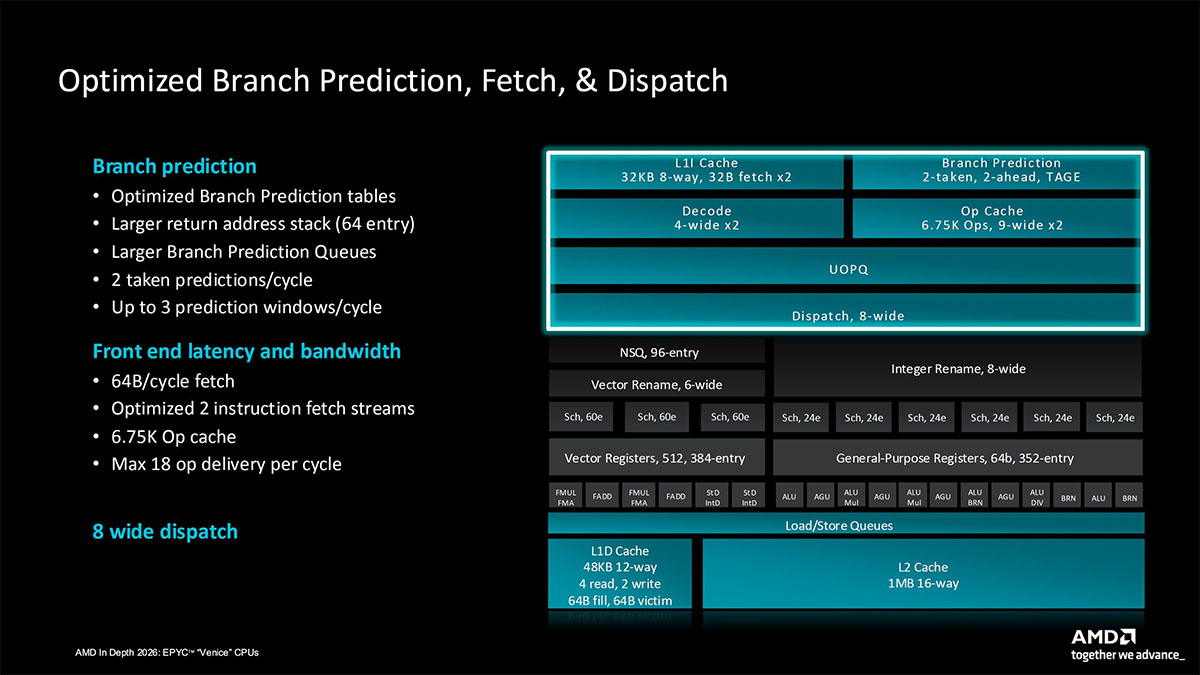
前端部分,Zen 6每周期取指64B,L1指令缓存为32KB 8路;op-cache条目从6K增至6.75K,每周期可输送的操作数从12条提升到18条,增幅达50%;返回地址栈从52项扩到64项,分支预测每周期最多给出2条taken预测、覆盖3个预测窗口,派发与重命名均为8宽。
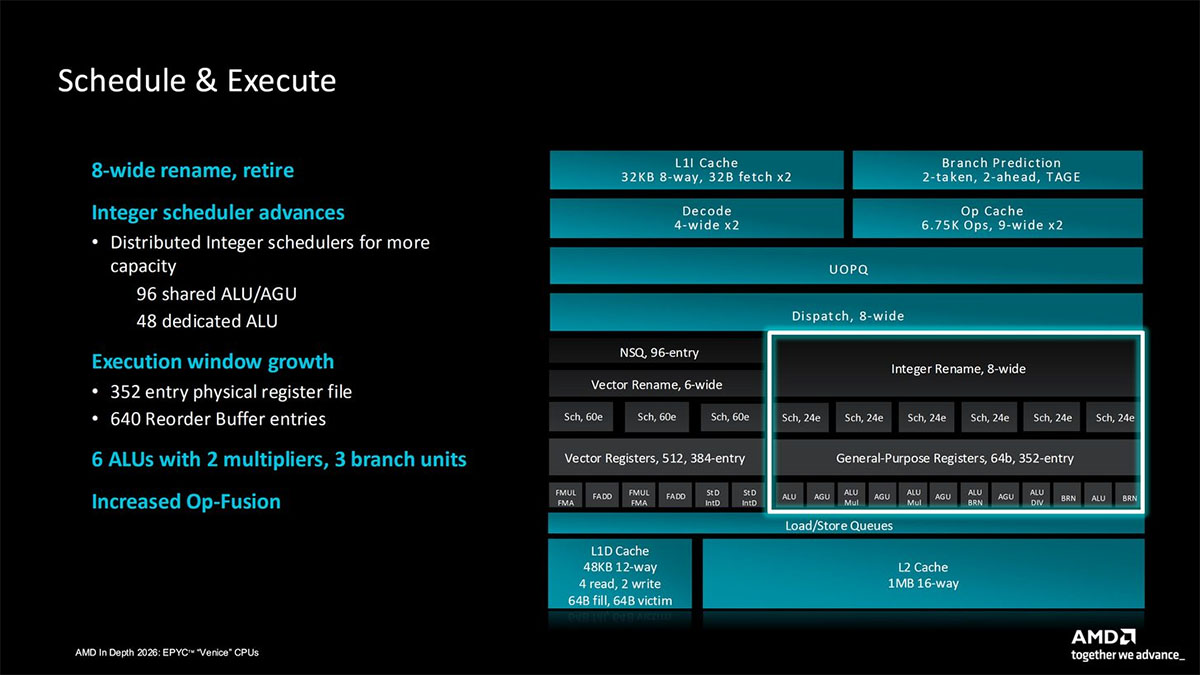
执行引擎为6个ALU(含2个乘法器)加3个分支单元,OP融合进一步增强;整数调度器从上代的统一式改为拆分加共享结构,提供96项ALU/AGU共享调度外加48项专用ALU调度;物理寄存器堆由240项增至352项,重排序缓冲(ROB)从448项增至640项。
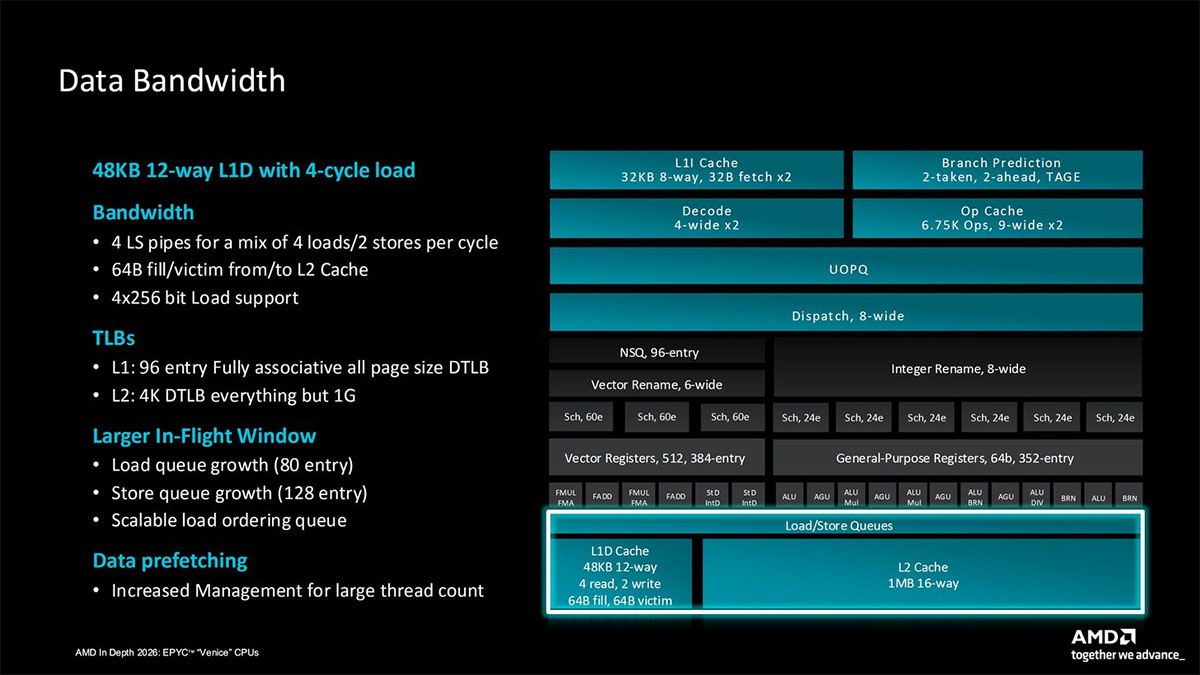
L1D容量增至48KB(12路),载入延迟4周期,每周期最多完成4次载入加2次存储;载入队列从64项增至80项,存储队列从96项增至128项;每核心L2为1MB(16路),L1与L2之间单次填充/逐出为64B。
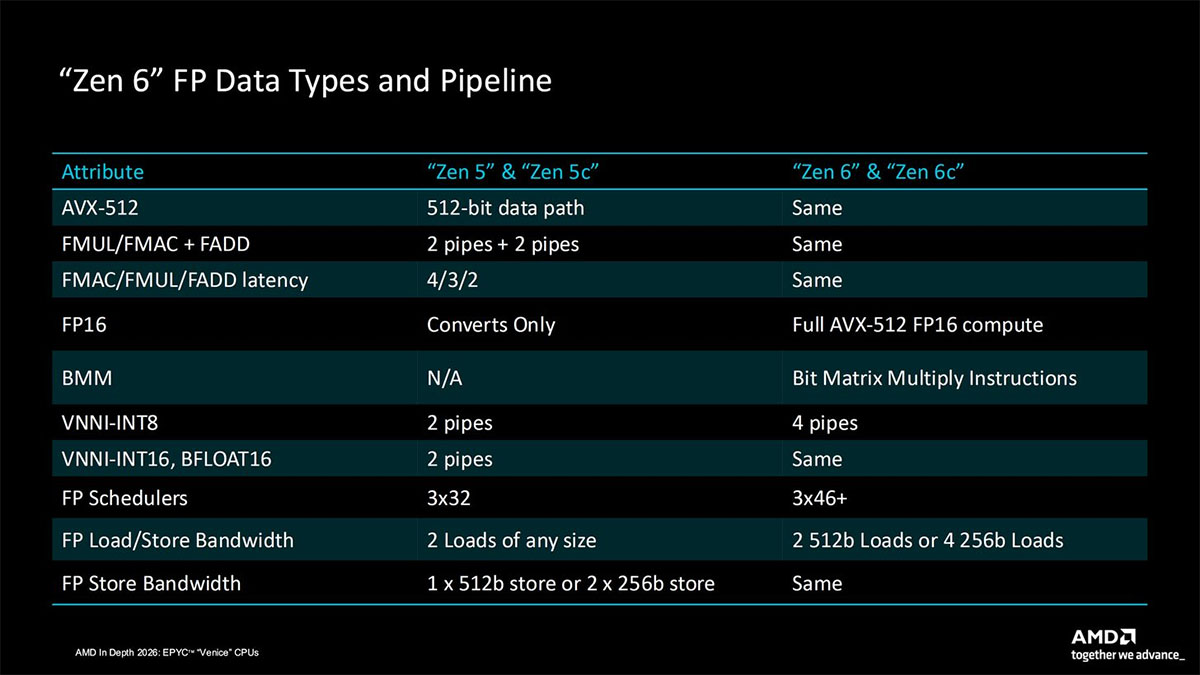
浮点与AI是这代改动最集中的地方:512位FP数据通路,FADD延迟2周期,FP调度器从3×38项增至3×60项,新增完整AVX-512 FP16算力与BMM位矩阵乘指令,VNNI-INT8管线从2条翻倍至4条。新ISA还包括AVX-NE-CONVERT(BF16/FP16转FP32)、AVX-VNNI-INT8、AVX-IFMA、FRED中断/异常/系统调用新接口、PML客户机脏页记录以及PLZA服务等级自动切换,另配备Memory Profiler内存剖析器与IBS缓冲。
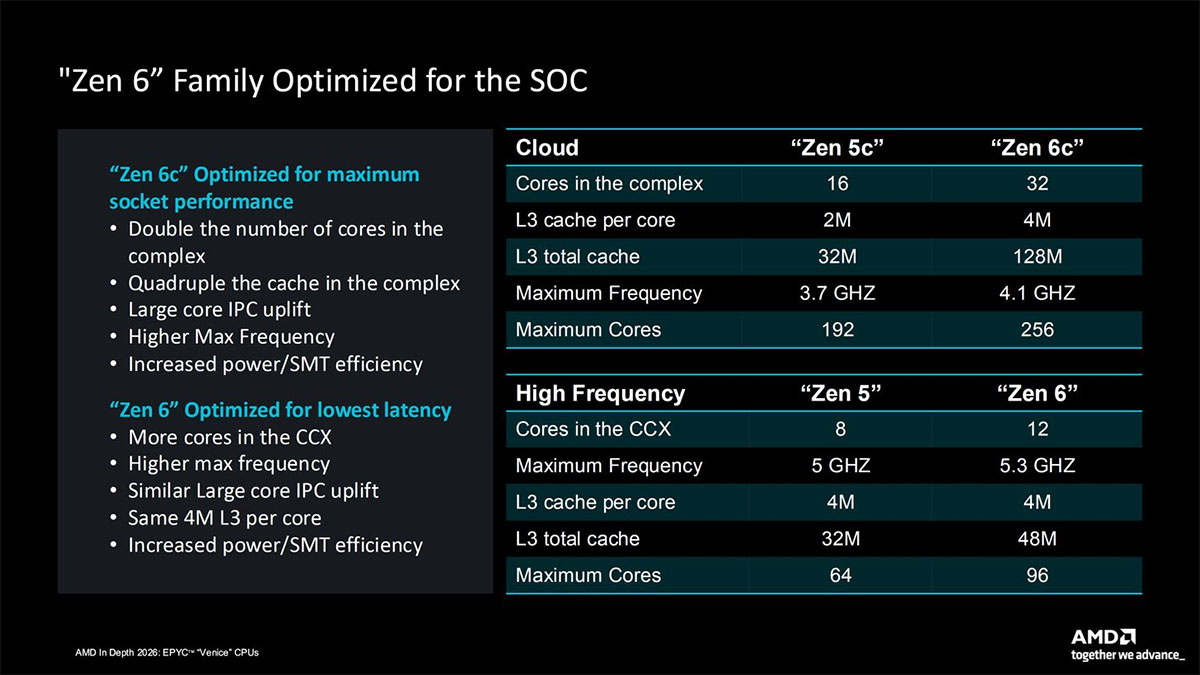
缓存与CCX拓扑上,两种核心的规模不同:Zen 6每个CCX最多12核、共享48MB 16路L3,单核L3维持4MB,最高频率5.3GHz,较Zen 5提升300MHz,单芯片最多96核;Zen 6C每个CCX最多32核、共享128MB L3,单核L3从上代的2MB翻倍至4MB,最高频率4.1GHz,较Zen 5c提高400MHz,单芯片最多256核512线程。
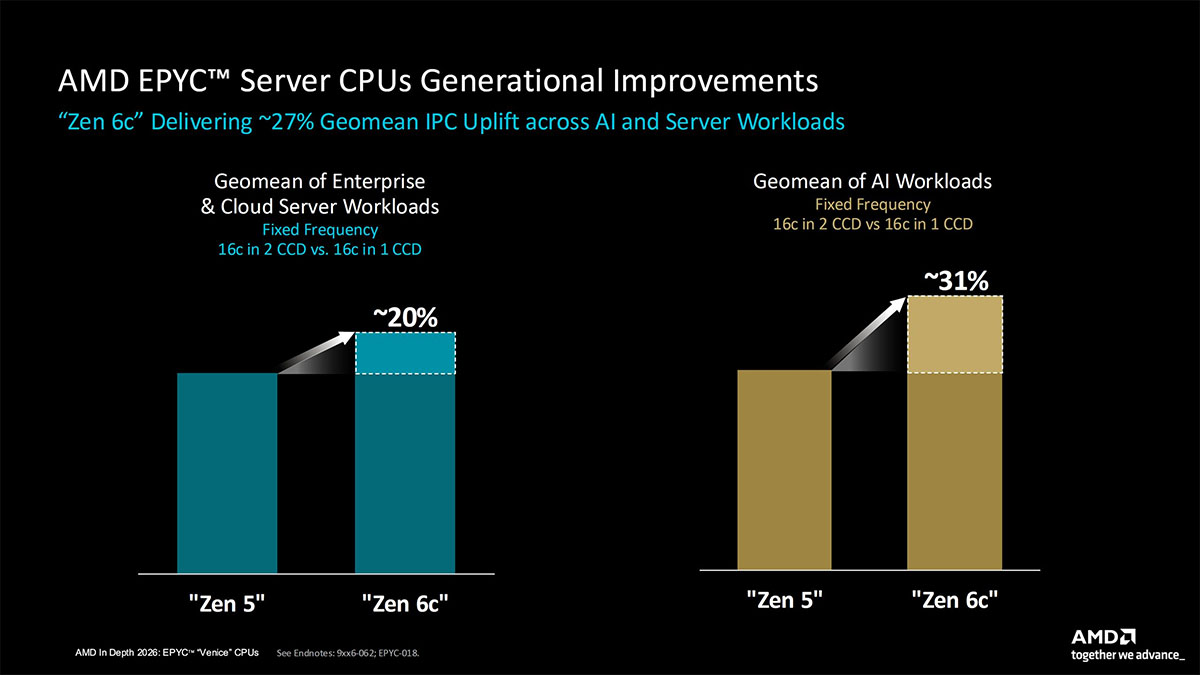
这些改动最后折算成约27%的IPC提升。AMD的对比口径是固定频率下,拿横跨两颗CCD的16核Zen 5对单CCD 16核的Zen 6C,其中企业与云负载提升20%,AI负载提升31%。
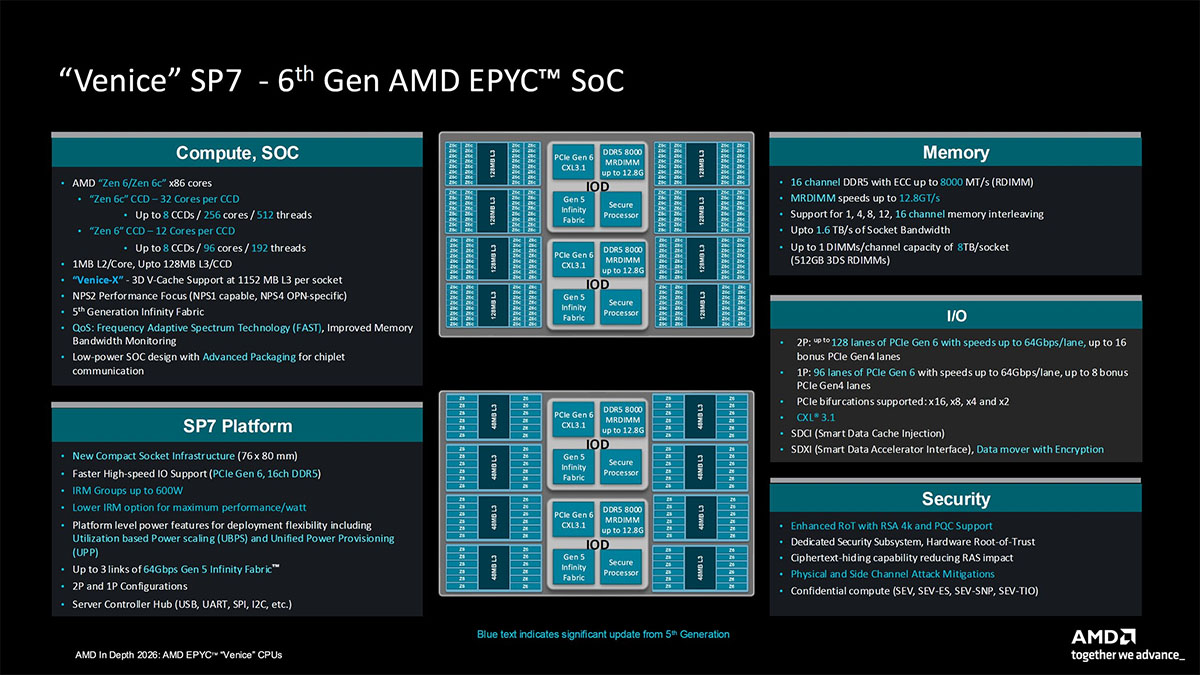
平台层面,SP7采用双IOD设计(N3工艺),最多搭配8颗CCD:Zen 6版本至多96核、总L3 384MB;Zen 6C版本至多256核512线程、总L3达1024MB,整颗芯片的L2总量相应为96MB或256MB。内存为16通道DDR5,支持12800MT/s的第二代MRDIMM,峰值带宽1.6TB/s。
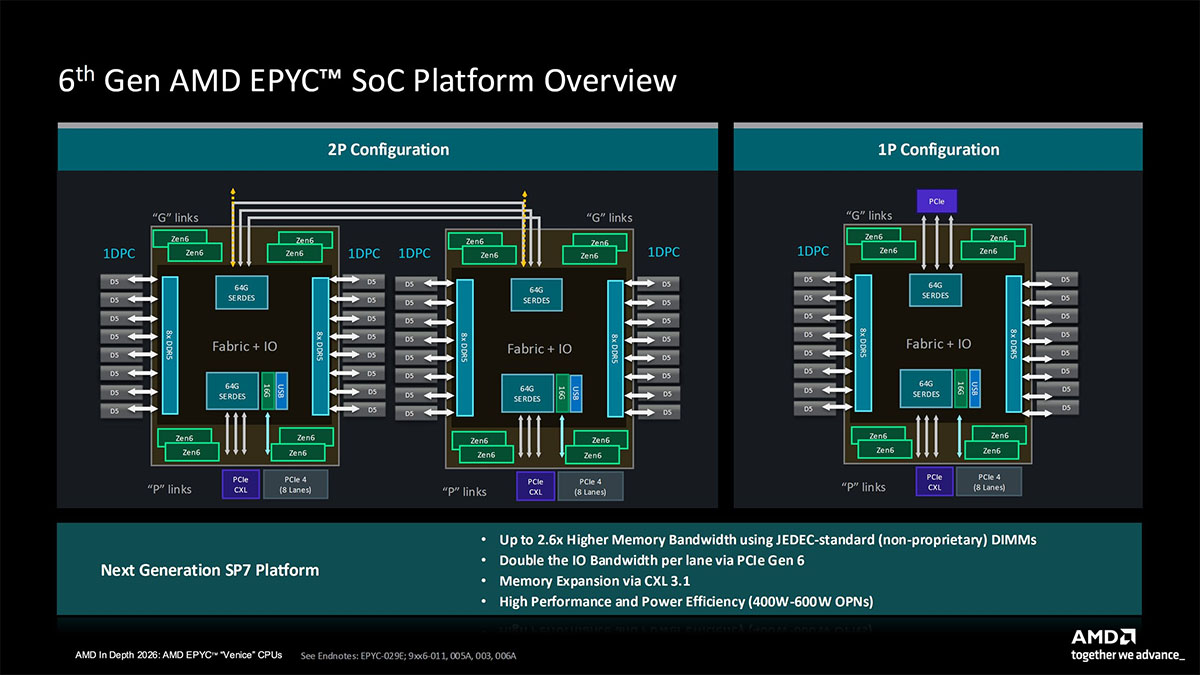
双路配置提供最多128条PCIe 6.0通道外加16条PCIe 4.0附加通道,单路为96条加8条。芯片间通过第五代Infinity Fabric互联,IOD内置SDCI智能数据缓存注入与SDXI智能数据加速接口,支持CXL 3.1,TDP最高600W。
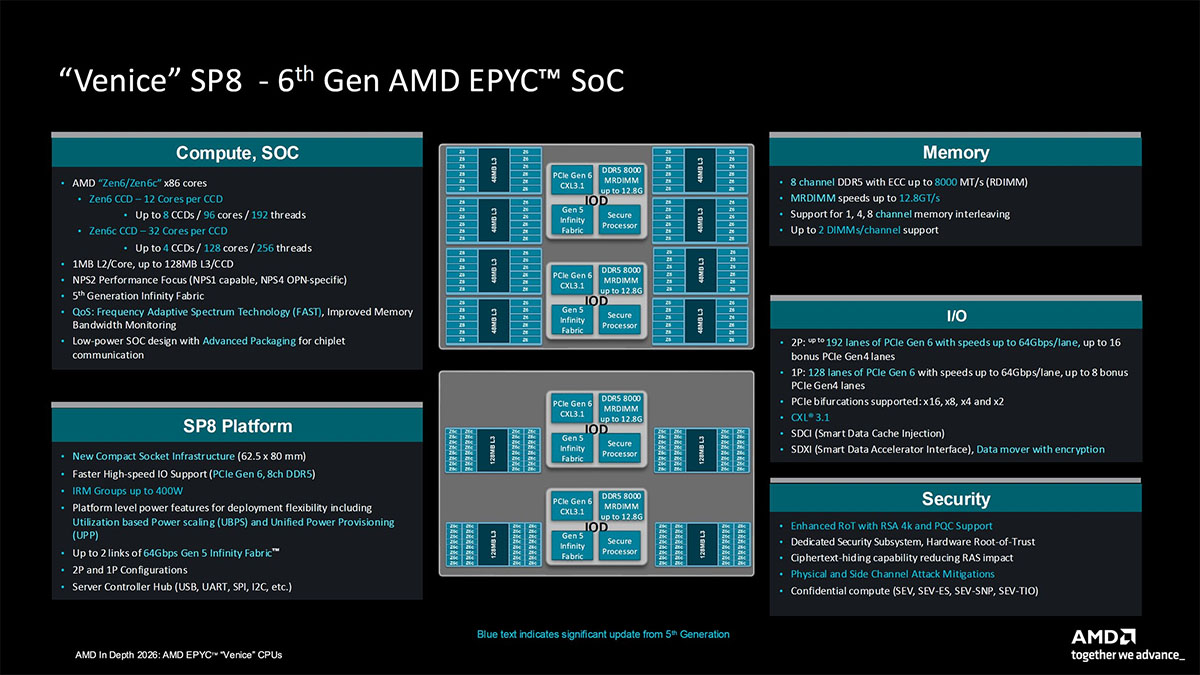
SP8是本届新增的主流平台,插座尺寸62.5×80mm,内存为8通道DDR5,RDIMM最高8000MT/s、MRDIMM同样支持到12800MT/s,峰值内存带宽为512GB/s(RDIMM)/819GB/s(MRDIMM)。核心配置上,Zen 6C至多4颗CCD、128核、512MB L3,Zen 6为8颗CCD、96核、384MB L3。
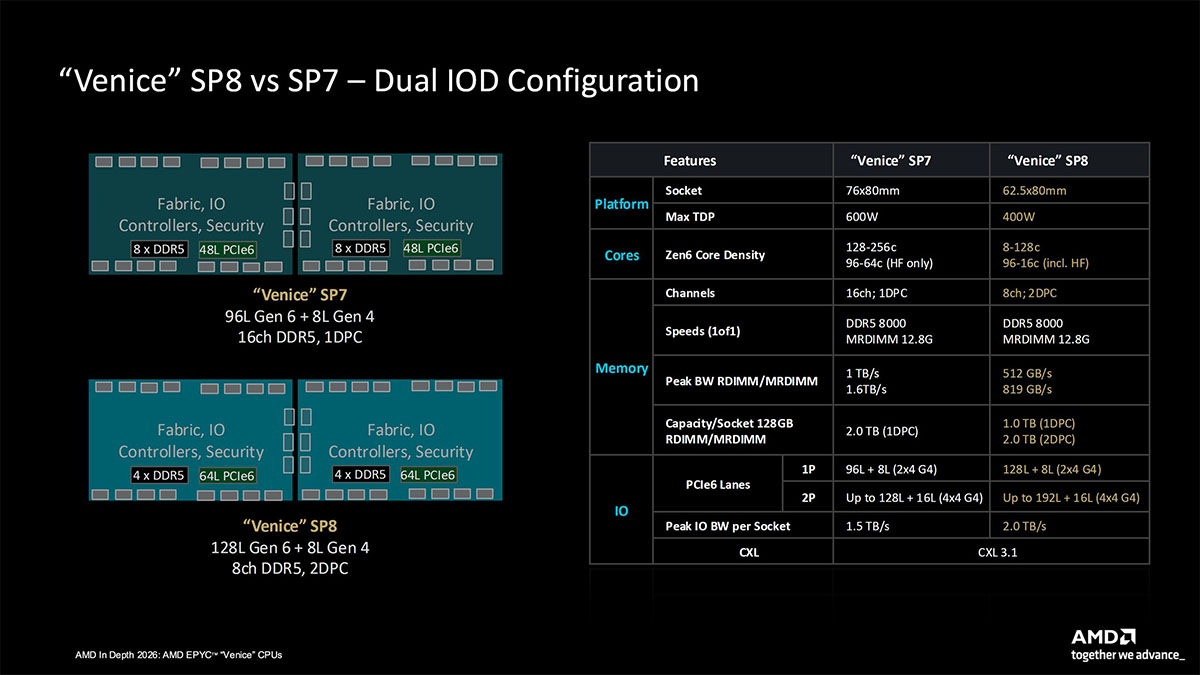
IO反而给得更足,双路平台最多提供192条PCIe 6.0通道加16条PCIe 4.0附加通道,单路峰值IO带宽2.0TB/s,高于SP7的1.5TB/s,TDP上限400W。Venice平台的内存生态还包括LPDDR5X SOCAMM2与MEXT;CXL 3.1在SP7与SP8上每路可分别扩展96条和128条通道,AMD称CXL可构建TB级内存层,每GB成本比DDR5低87%,应用无需修改即可兼容。
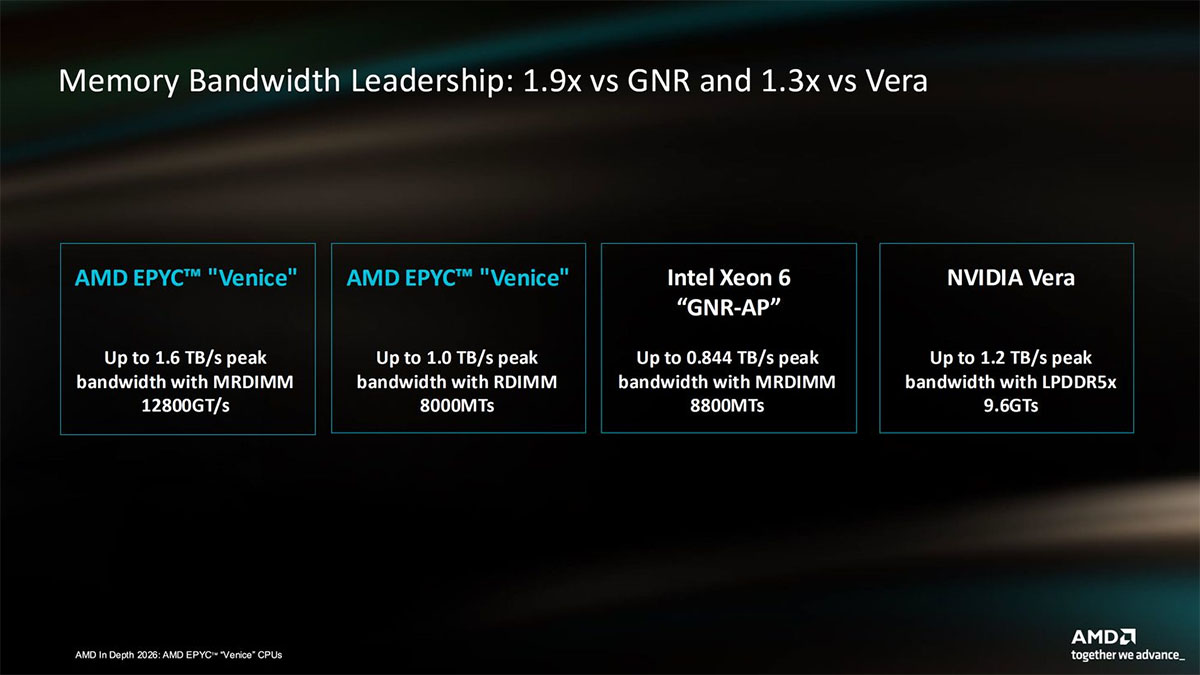
内存带宽上,Venice搭配MRDIMM可达1.6TB/s,高于NVIDIA Vera(LPDDR5X SOCAMM2)的1.2TB/s;即便只配8000MT/s RDIMM,也领先于用上初代8800MT/s MRDIMM的Granite Rapids-AP(1.0TB/s对0.844TB/s)。
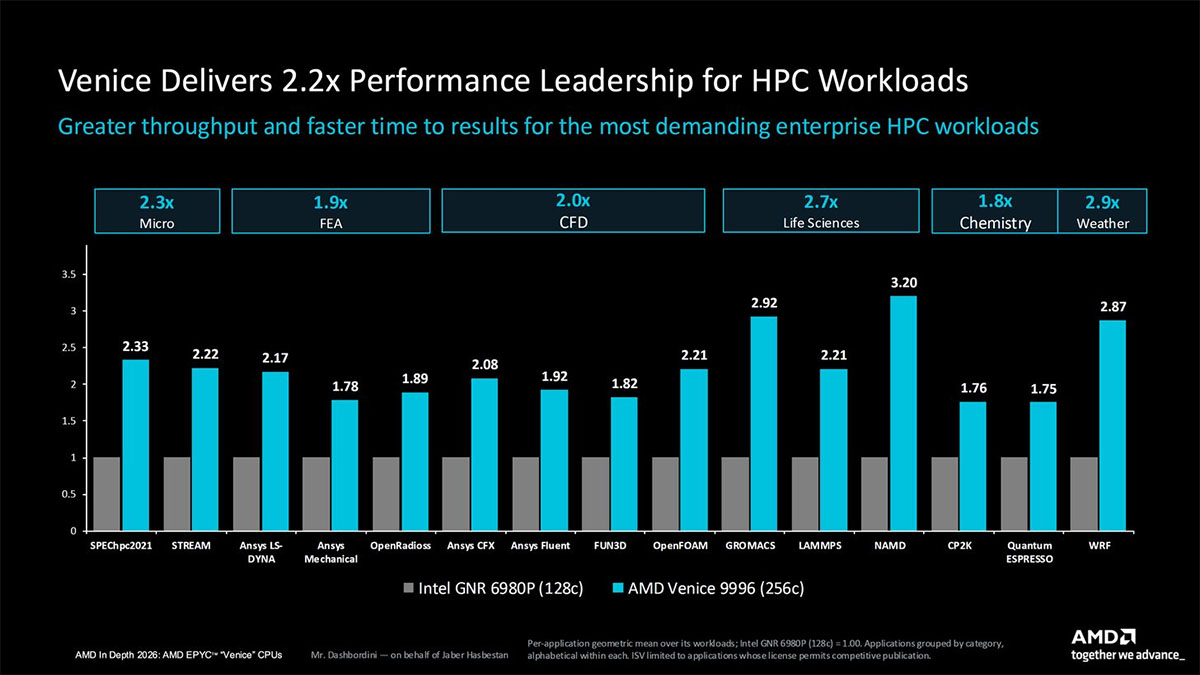
HPC上,EPYC 9996(256核)对比Xeon 6 6980P(128核)平均领先2.2倍、最高3.2倍,96核的9686F也能对128核旗舰形成1.6倍优势,相近核数下平均领先1.9倍。
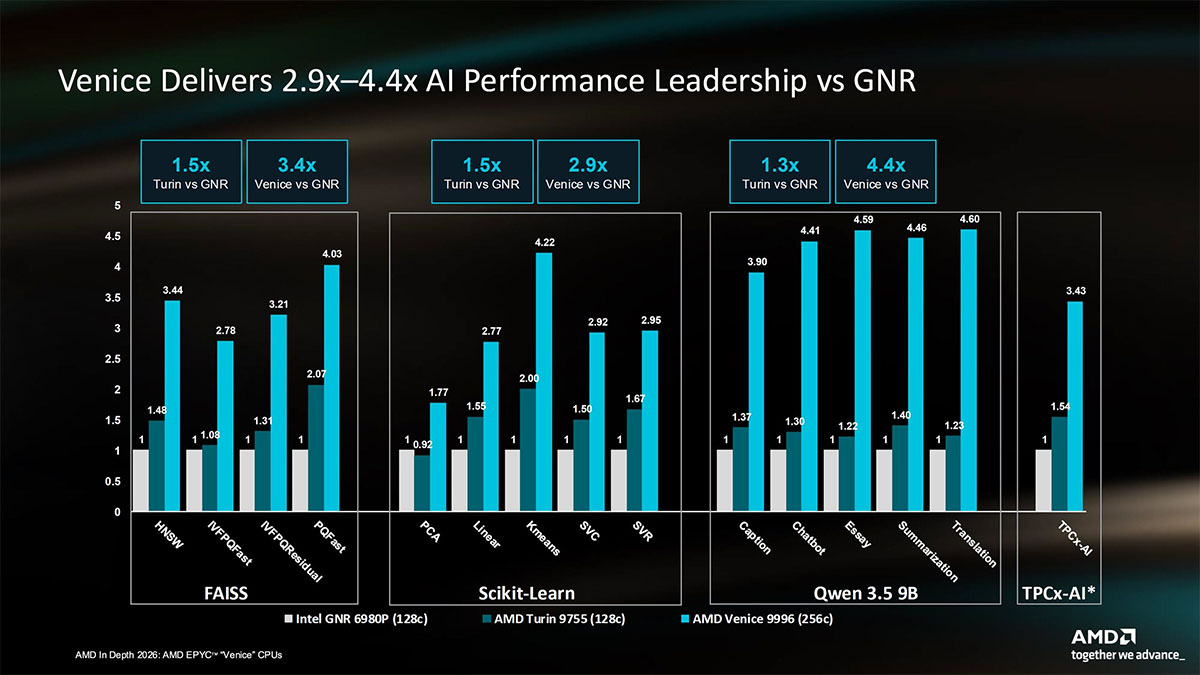
AI负载方面,Venice对Granite Rapids的领先幅度为2.9至4.4倍,覆盖FAISS、Scikit-Learn、Qwen 3.5 9B与TPCx-AI等测试;对比Vera则宣称每MW线程数最高2.9倍、每MW性能最高2.0倍、单机架核心密度更高,对AWS Graviton5的领先幅度为3.0倍。
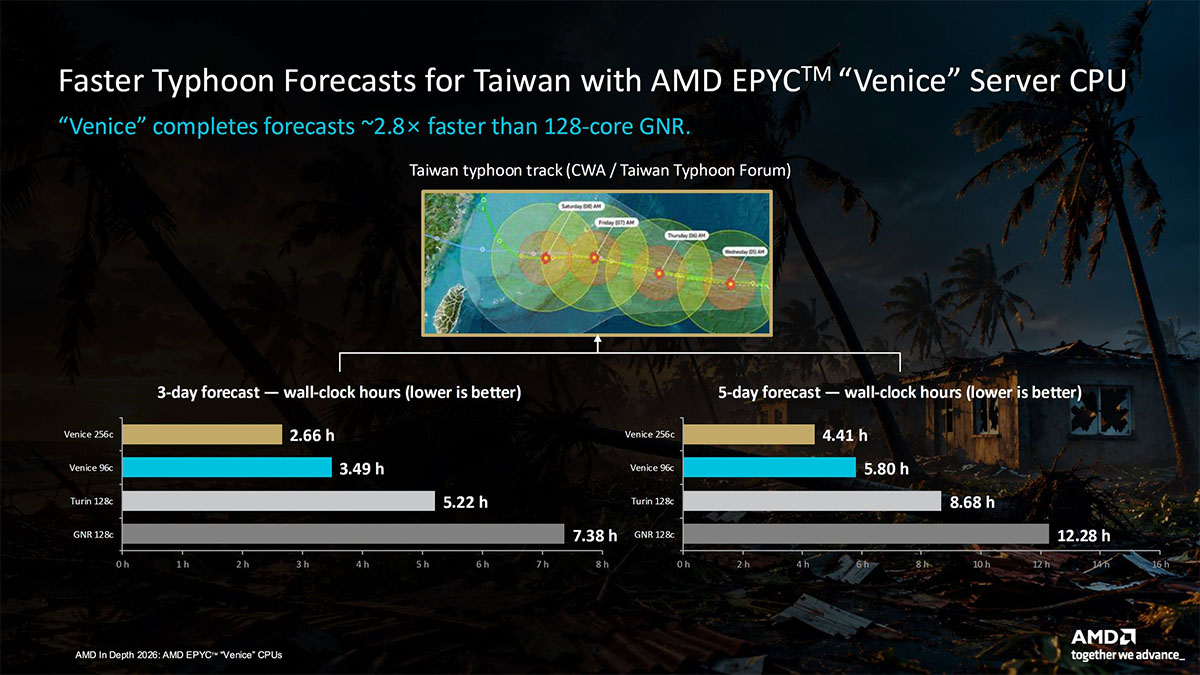
台风路径预报中,3天预报256核Venice只需2.66小时,96核为3.49小时,而128核Turin需要5.22小时;100ns分子动力学模拟,256核Venice耗时57天,96核为97天,128核Turin为114天,Granite Rapids则要182天,前后差了约4个月。拉长到六代产品看,AMD宣称通用计算吞吐提升约20倍、科学计算提升18.6倍、内存带宽提升9.6倍。
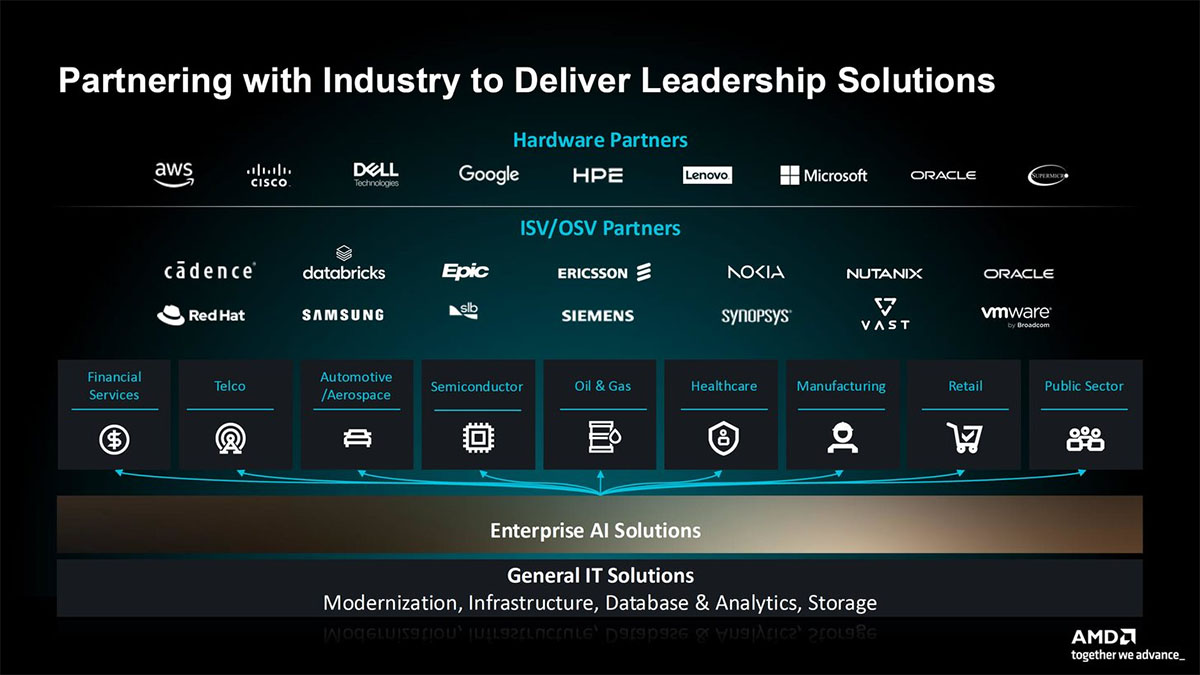
Dell、Google、Microsoft等硬件与云厂商,以及Cadence、Ericsson、Nokia、Databricks等ISV均已宣布支持,搭载Venice的服务器将陆续上市。AMD同时预告了2027年的Venice-X:96核堆叠1152MB的3D V-Cache,加速频率最高5.3GHz,号称迄今最强的3D V-Cache处理器。