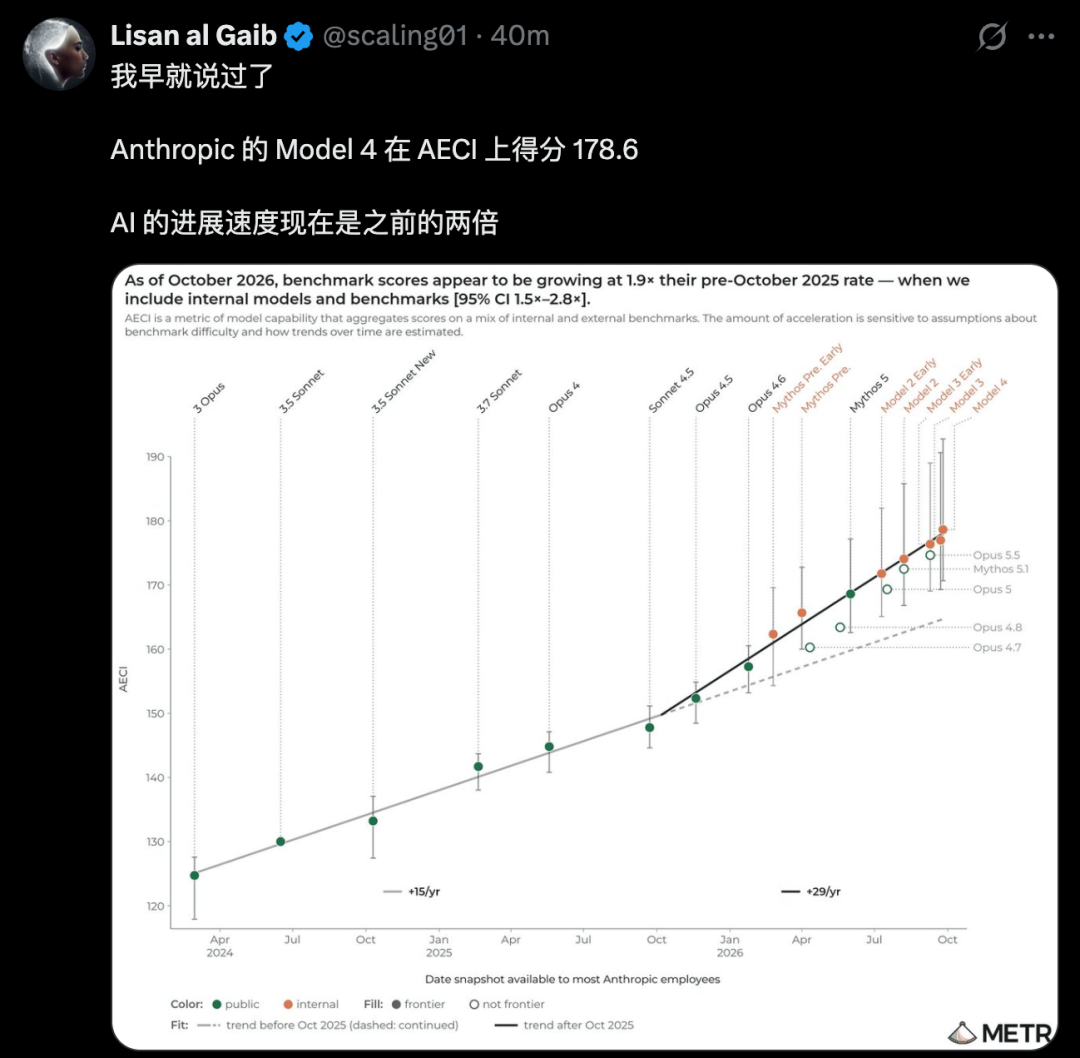
Anthropic 内部模型 Model 4 在 AECI 拿到 178.6,超过公开的 Opus 5.5 与 Mythos 5.1。METR 的调查认为 2025 年 10 月之后模型能力增速约为此前的 1.9 倍,其中约 80% 来自 AI 参与研发工作。
如果一款内部模型在 9 到 10 月完成训练,AECI 综合能力指数达到 178.6,超过公开的 Opus 5.5 和 Mythos 5.1,真正值得讨论的就不只是“Model 4 有多强”,而是模型研发速度本身是否正在加速。
METR 最近发布的一份调查,把 Anthropic 内部未公开模型、研发自动化和能力增长趋势放在了一起。报告认为,2025 年 10 月之后,Anthropic 模型的能力进步速度约为此前的 1.9 倍;而这轮加速中,约 80% 可能来自 AI 对研发工作的参与。
这些信息主要来自第三方评测、内部访谈和公开风险文件,不能等同于 Anthropic 已正式发布 Model 4,也不能直接证明 RSI 已经发生。更适合把它看成一个工程预警:当 Agent 能够帮助研发更强的 Agent,团队需要同时升级评测、权限和安全治理。
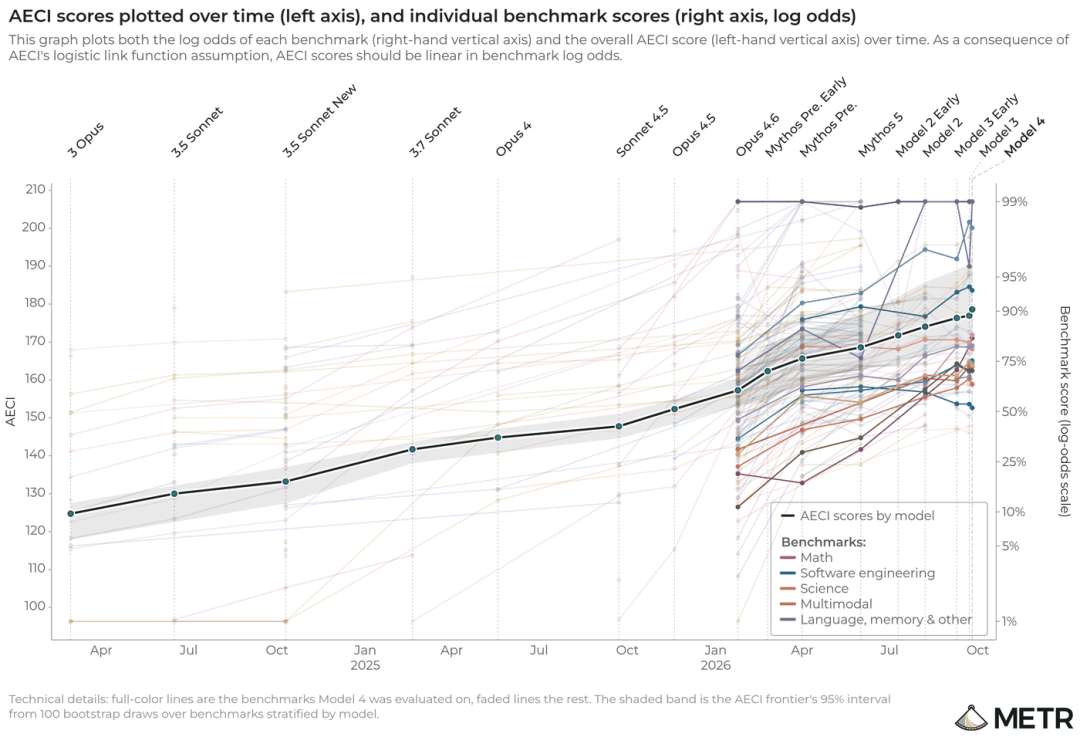
神秘Model 4,AECI冲到178.6
METR 在附录中列出了四款内部未公开模型:2022 年训练完成的 Unreleased 2022、2026 年 7 月训练完成的 Model 2、8 到 9 月训练完成的 Model 3,以及 9 到 10 月刚完成训练的 Model 4。
Model 4 的 AECI 得分为 178.6,高于公开模型 Opus 5.5 的 174.5 和 Mythos 5.1 的 172.5。AECI 可以理解为把多个能力基准折算成的综合指标,但它不是一个可以脱离测试集、任务分布和评测设置单独解释的“智力分数”。
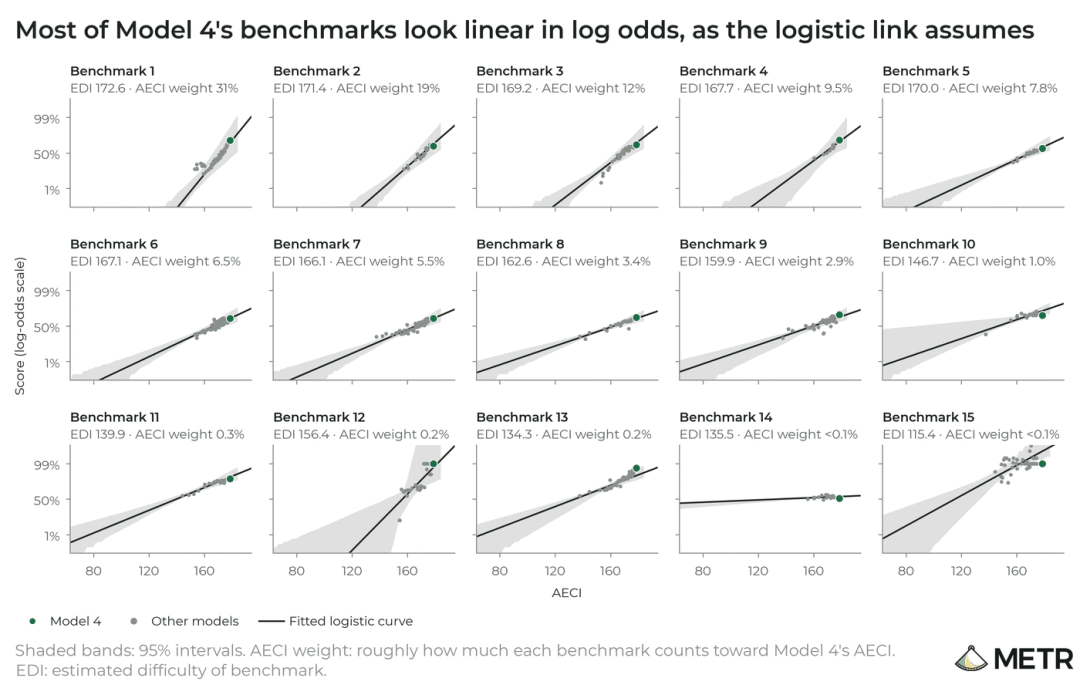
Model 4 参加的 15 项基准测试,每一项正确率都超过 50%。9 个月前,Opus 4.6 还有不少测试无法过半。METR 还发现其中 15 个测试有 3 个存在长尾过难或题目损坏的问题,剔除后重新计算,Model 4 的 AECI 可能再增加 1.1 分,达到 179.7。
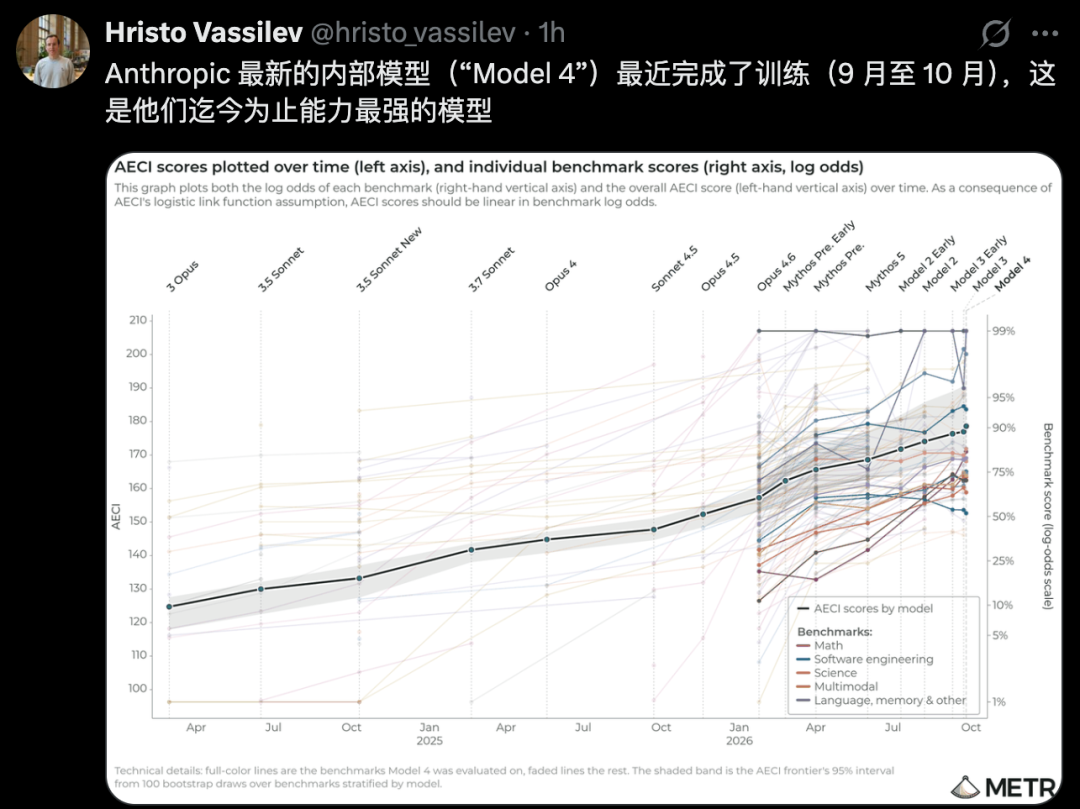
这类结果也提示评测工程的难度正在上升:当模型接近测试上限时,题目损坏、长尾样本和 Token 预算都会影响结论。下一代评测不能只增加题目数量,还要检查任务有效性、难度分布、污染风险和模型是否真正完成了任务。
一次任务消耗千万Token,现有考卷快压不住了
METR 的调查还记录了 Model 4 的 Token 消耗。普通基准任务平均消耗约 250 万输入 Token 和 7 万多输出 Token;如果让 Agent 完成代码任务,单任务输入可能达到约 1000 万 Token,输出也接近 9.4 万 Token。
对于开发者来说,模型能力不能脱离任务成本评估。一次看似成功的代码任务,如果消耗了数百万 Token、经历多轮工具调用和长时间等待,真实交付成本可能远高于单次 API 价格。
建议把 Agent 评测拆成四项:
- 完成质量:测试是否通过,代码是否可维护。
- 轨迹质量:工具调用是否有效,是否陷入重复循环。
- 资源成本:输入、输出、缓存、运行时间和并发占用。
- 人工成本:审查、返工、回滚和事故处理耗时。
如果模型一直刷题、刷代码或刷实验,却没有带来相应的有效产出,Token 消耗越高不代表能力越强。模型越能自主执行,预算、停止条件和任务检查点就越重要。
2025年10月是能力增速的转折点
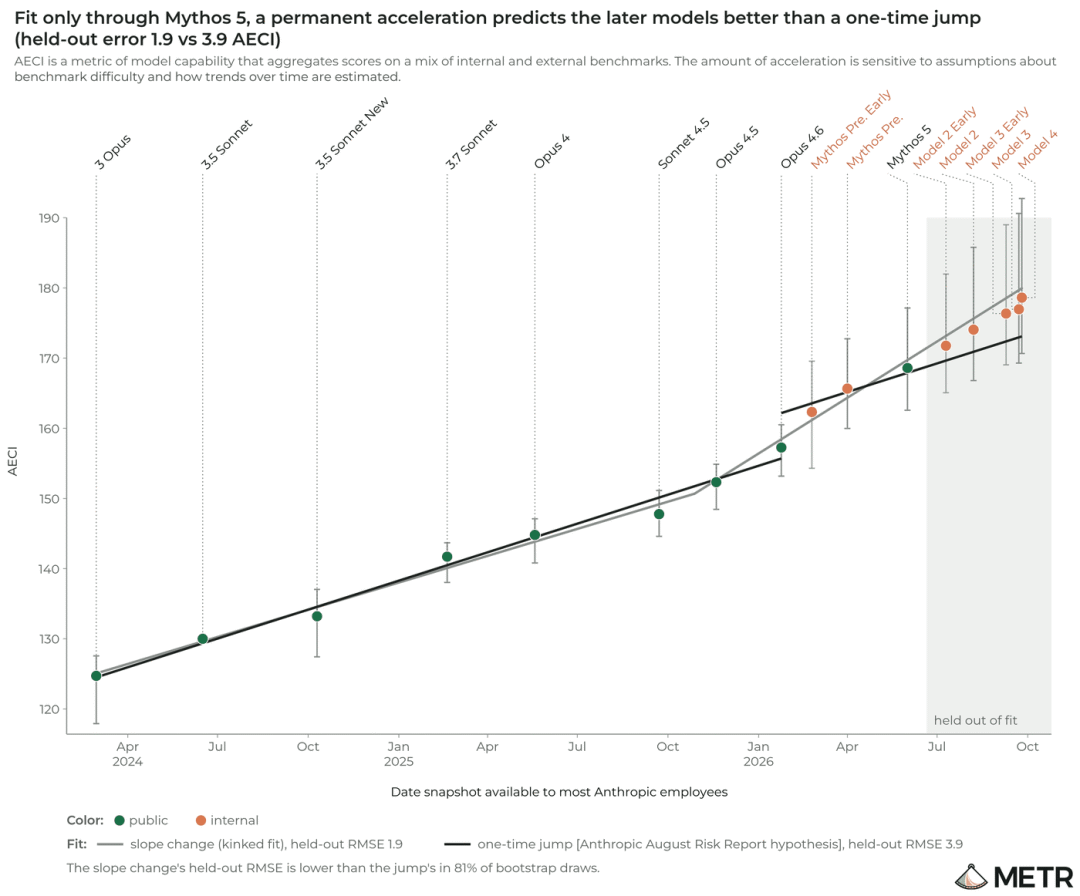
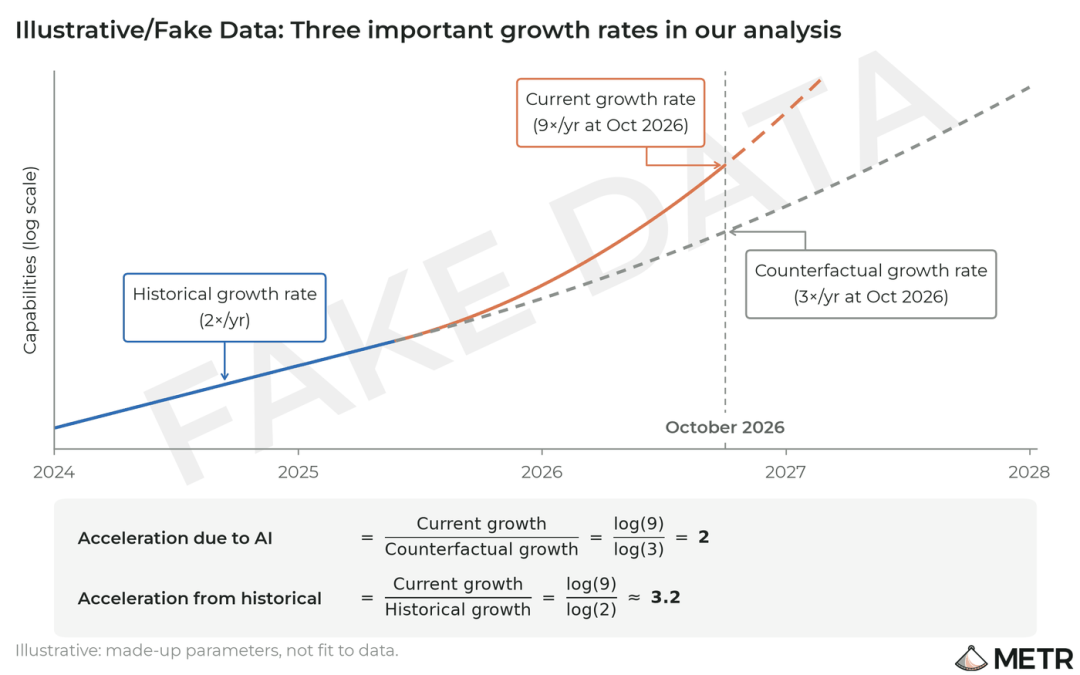
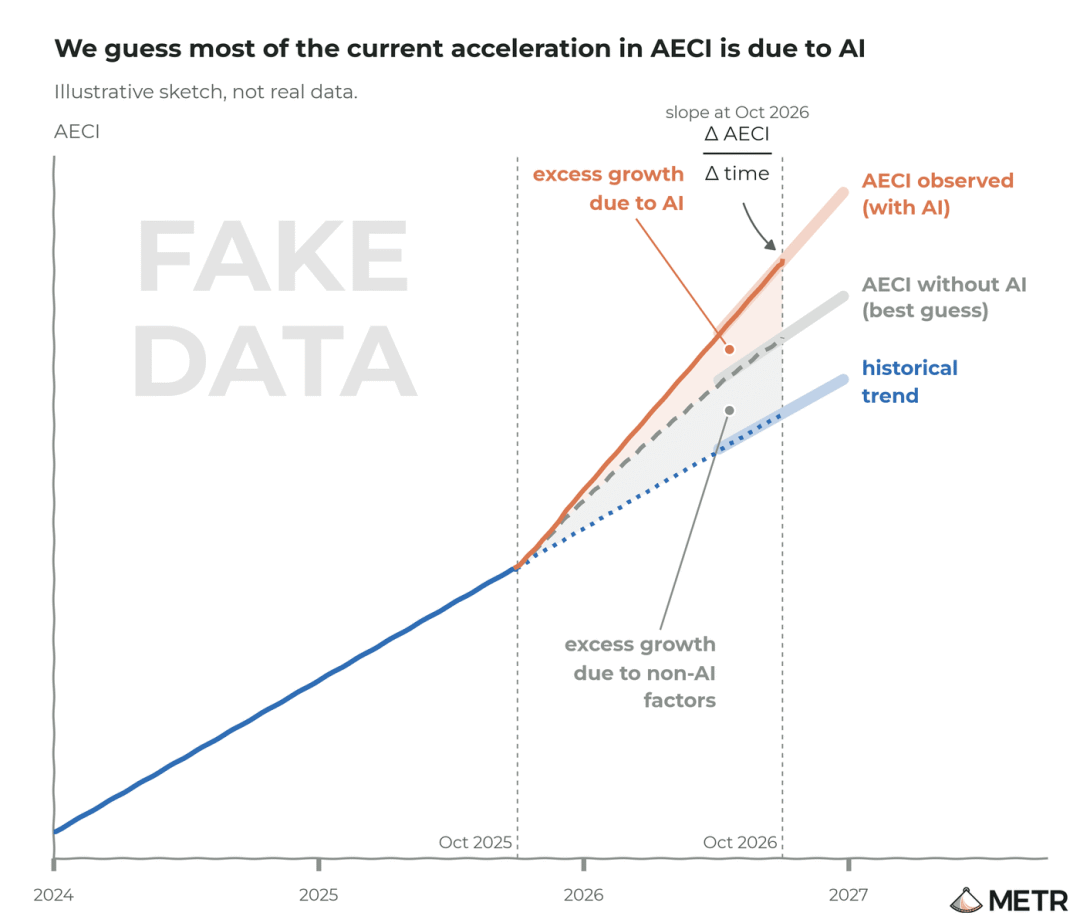
METR 把 2025 年 10 月 7 日视为一个重要分界点。在此前的阶段,Anthropic 模型 AECI 得分每年大约增长 15 分;从 2025 年 10 月开始,曲线变成每年增长约 29 分,增速约为过去的 1.9 倍,95% 置信区间为 1.5 到 2.8 倍。
Anthropic 今年 8 月的风险报告曾提出一种较温和的解释:增速变化可能只是新工具和新评测方法带来的一次性台阶。METR 随后进行盲测,用 Mythos 5 及更早模型的数据画出两条预测线,再去预测后续 Model 2、Model 3、Opus 5.5 和 Model 4。
结果显示,在 81% 的统计抽样中,“长期持续提速”预测误差约 1.9 分,而“一次性跳涨”预测误差达到 3.9 分。这个结果更支持持续加速假设,但它仍然是统计模型对已有数据的解释,不是未来必然沿着同一曲线发展的证明。
80%的研发加速,可能来自AI自己
为了判断增速来源,METR 把训练算力、算法和人员投入拆开分析。报告认为,2025 年 10 月之后训练算力的增长率反而比此前更慢,因此不能简单把能力提升归因于堆算力。
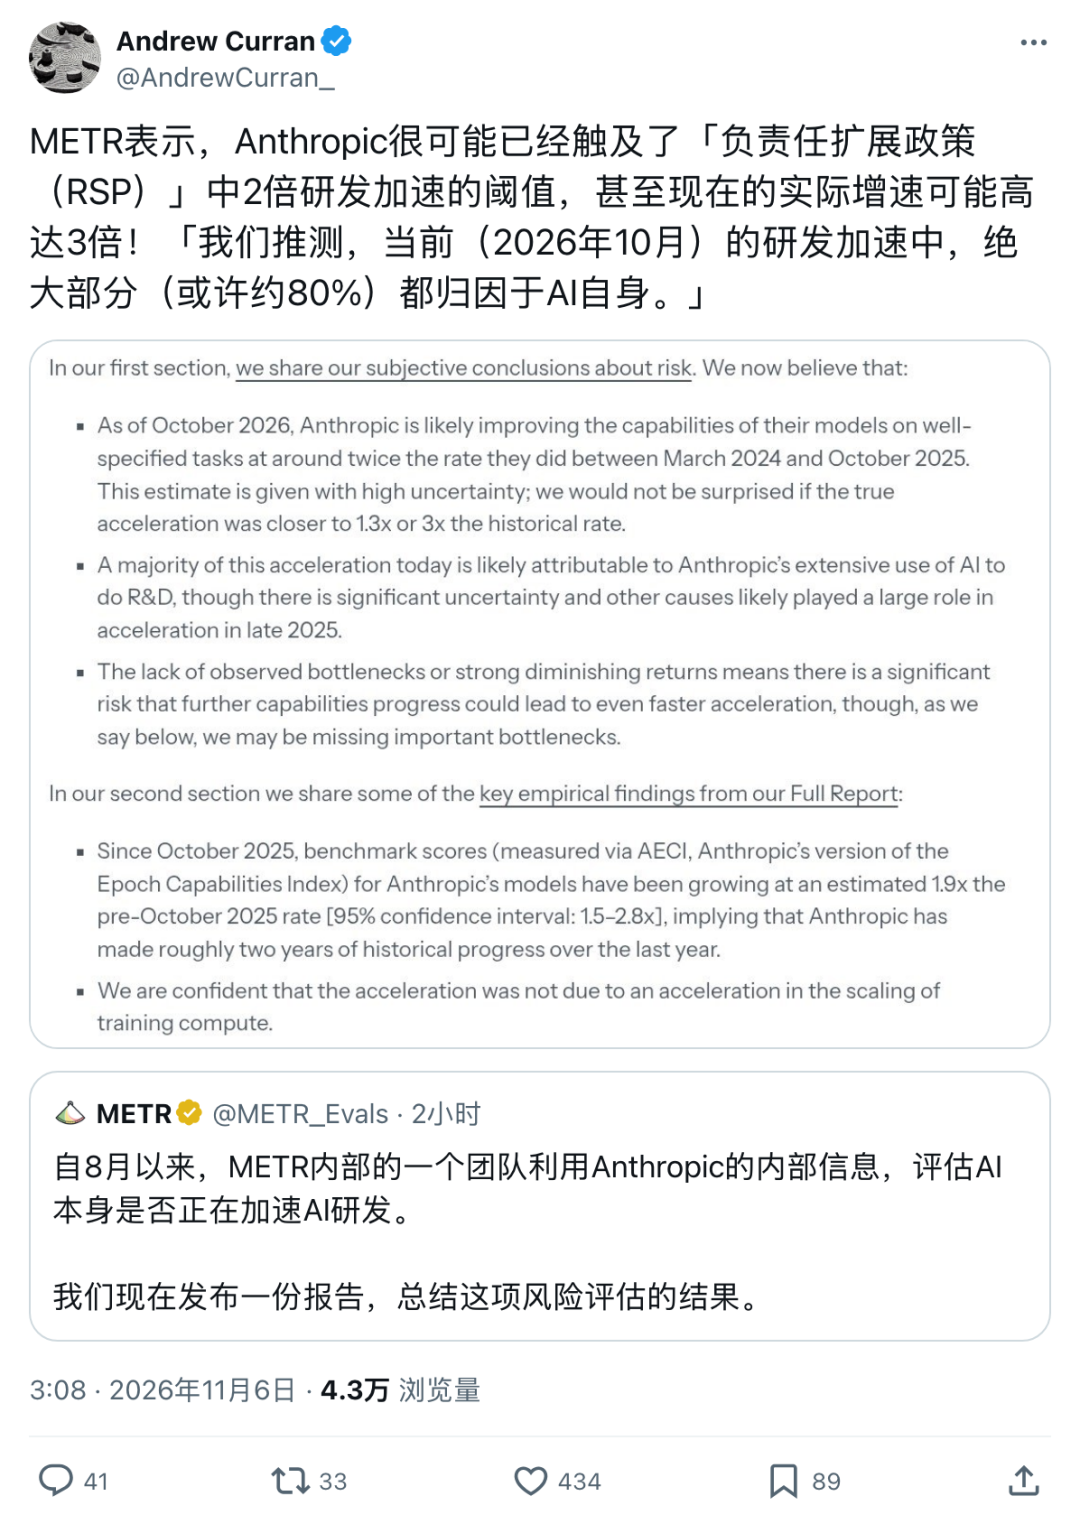
真正值得关注的是研发自动化:METR 估算,当前约两倍的研发加速中,大约 80% 来自 AI 对研发工作的辅助,其余才来自研究员数量增加和推理算力扩容。
这里的“AI 辅助研发”不是一句宣传语,而是具体工作流变化:Agent 写实验代码、运行基准、处理数据、生成评估结果,研究员可以同时启动多个方向,再决定哪些结果值得继续。
如果 10 个研究点子同时交给 Agent 试跑,研究瓶颈就会从“写代码”转向“想出好点子、判断结果和获得算力”。这会显著提高探索宽度,但也会带来更多无效实验、更多 Token 消耗和更高的安全审查压力。
内部研究员自报提速12倍,工作方式变了
METR 通过内部非正式调查和 Slack 全员投票观察 Anthropic 研究员的工作变化。2025 年春天使用 Claude 3.7 Sonnet 和 Opus 4 时,研究员自报效率提升约 1.3 到 1.4 倍;今年 6 月使用 Mythos 5 时,提速约 5 倍;10 月使用 Model 4 时,自报研发提速达到约 12 倍。
这些是自报数据,不应直接当作严格的生产效率指标,但可以帮助理解工作方式的变化。研究员经历了三个阶段:先把 Claude 当作自动补全,后来让单个 Claude 实例开发完整功能,再到同时指挥一群 Agent 并行跑实验。
内部悬赏鼓励研究员把平时不敢尝试的点子交给 Agent。有人同时把 10 个研究想法交给系统,先观察哪个方向能跑出结果;有人表示,从想法到实验跑通的时间缩短了约 80%。
这种模式的工程版本就是并行实验调度器:每个 Agent 在独立分支、独立环境和独立预算中运行,统一回收结果,由研究员比较指标后决定下一轮。没有隔离和预算控制,多 Agent 并行只会变成一组不可追踪的后台任务。
自进化为什么还没有刹车
METR 向 Anthropic 提交了约 100 页完整报告,但公开版本删掉了大量核心证据,多个敏感位置出现 [REDACTED]。这说明相关结论仍然存在信息不完整的问题,外界无法直接复核所有内部数据。
报告提出,未来 12 个月内,算法、算力和数据都没有出现明显的硬性瓶颈,能够让这台研发加速机器自然停下。更强的 Claude 帮研究员省下实验时间,省下来的时间又可以用于孵化更强的模型,反馈循环由此形成。
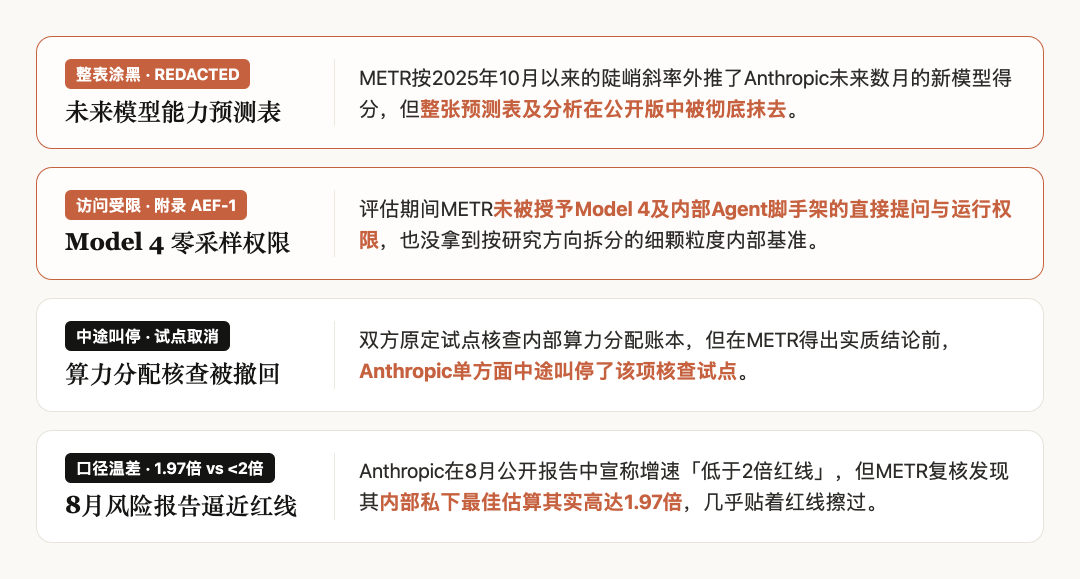
对开发者而言,最应该借鉴的不是“让 AI 自己变强”,而是把反馈闭环拆成可审计步骤:任务目标、工具权限、实验输入、模型输出、评估结果、人工判断和下一轮变化都要留痕。
给Agent研发流程补上四道闸门
当 Agent 参与模型研发时,至少需要四道独立闸门:
- 数据闸门:训练、评估和红队数据分开,防止测试集污染。
- 权限闸门:Agent 只能访问任务所需目录、工具和临时凭据。
- 评估闸门:评估器、基准和停止条件不能由执行模型自行修改。
- 发布闸门:模型、代码、权重和安全策略变更必须经过人工审批和可回滚版本。
国内开发者如果需要将 Claude Code 等工具接入兼容 API,可通过 Code80(https://code.ai80.vip/home) 配置 endpoint;实验环境、模型权限、密钥、预算和生产审计仍应由项目侧管理。
常见问题
Model 4已经正式发布了吗?
没有。Model 4 是 METR 调查中列出的 Anthropic 内部未公开模型,公开材料不足以证明 Anthropic 已正式发布或确认其完整能力。
AECI 178.6代表模型全面领先吗?
不代表。AECI 是综合评测指标,仍受基准选择、题目质量、Token 预算和任务分布影响,需要结合真实任务成功率和独立复现判断。
研发速度翻倍等于AI已经自主研发模型了吗?
不等于。AI 目前可以参与代码、实验、评估和数据处理,但研究目标、结果价值和发布决策仍需要人类判断。
为什么要关注Agent的Token成本?
因为长程研发任务会消耗大量输入和输出 Token。只看一次任务是否成功,不统计工具调用、重试、运行时间和人工返工,容易低估真实成本。
如何在团队中安全使用研发Agent?
使用隔离分支、沙箱、路径白名单、短期凭据、任务预算、独立评估器、人工审批和完整审计日志,避免执行模型同时拥有研发和发布权限。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,同时自行管理模型权限、实验数据、密钥、工具网关和审计日志。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自作者提供