作为 Go 并发原语的第一篇文章,一定绕不开 Go 的并发哲学。从 Tony Hoare 写的 Communicating Sequential Processes 这篇文章说起,这篇经典论文算是 Go 语言并发原语的根基。
一. What is CSP
CSP 的全程是 Communicating Sequential Processes,直译,通信顺序进程。这一概念起源自 1978 年 ACM 期刊中 Charles Antony Richard Hoare 写的经典同名论文。感兴趣的读者可以看 Reference 中的第一个链接看原文。在这篇文章中,Hoare 在文中用 CSP 来描述通信顺序进程能力,姑且认为这是一个虚构的编程语言。该语言描述了并发过程之间的交互作用。从历史上看,软件的进步主要依靠硬件的改进,这些改进可以使 CPU 更快,内存更大。Hoare 认识到,想通过硬件提高使得代码运行速度快 10 倍,需要付出 10 倍以上的机器资源。这并没有从根本改善问题。
1. 术语和一些例子
尽管并发相对于传统的顺序编程具有许多优势,但由于其会出错的性质,它未能获得广泛的欢迎。Hoare 借助 CSP 引入了一种精确的理论,可以在数学上保证程序摆脱并发的常见问题。Hoare 在他的 Learning CSP(这是计算机科学中引用第三多的神书!)一书中,使用“进程微积分”来表明可以处理死锁和不确定性,就像它们是普通进程中的最终事件一样。进程微积分是一种对并发系统进行数学化建模的方式,并且提供了代数法则来进行这些系统的变换来分析它们的不同属性,并发和效率。
为了防止数据被多线程破坏,Hoare 提出了临界区的概念。进程进入临界区后可以获得对共享数据的访问。在进入临界区之前,所有其他的进程必须验证和更新这一共享变量的值。退出临界区时,进程必须再次验证所有进程具有相同的值。
保持数据完整性的另一种技术是通过使用互斥信号量或互斥量。互斥锁是信号量的特定子类,它仅允许一个进程一次访问该变量。信号量是一个受限制的访问变量,它是防止并发中竞争的经典解决方案。其他尝试访问该互斥锁的进程将被阻止,并且必须等待直到当前进程释放该互斥锁。释放互斥锁后,只有一个等待的进程可以访问该变量,所有其他进程继续等待。
1970年代初期,Hoare 基于互斥量的概念开发了一种称为监视器的概念。根据 IBM 编写的 Java 编程语言 CSP 教程:
“A monitor is a body of code whose access is guarded by a mutex. Any process wishing to execute this code must acquire the associated mutex at the top of the code block and release it at the bottom. Because only one thread can own a mutex at a given time, this effectively ensures that only the owing thread can execute a monitor block of code.”
monitor 可以帮助防止数据被破坏和线程死锁。在 CSP 论文中为了说明清楚进程之间的通信,Hoare 利用 ?和 !号代表了输入和输出。!代表发送输入到一个进程,?号代表读取一个进程的输出。每个指令需要指定具体是一个输出变量(从一个进程中读取一个变量的情况),还是目的地(将输入发送到一个进程的情况)。一个进程的输出应该直接流向另一个进程的输入。
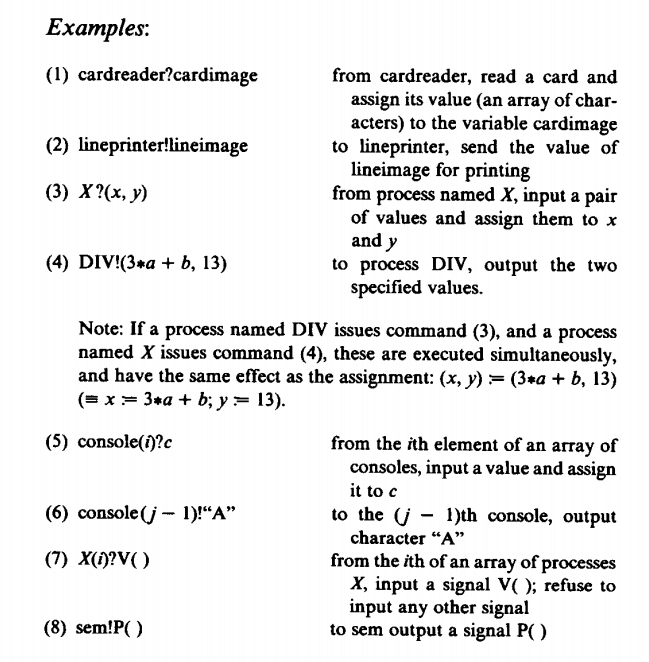
上图是从 CSP 文章中截图的一些例子,Hoare 简单的举了下面这个例子:
[c:character; west?c ~ east!c] 上述代码的意思是读取 west 输出的所有字符,然后把它们一个个的输出到 east 中。这个过程不断的重复,直到 west 终止。从描述上看,这一特性完完全全是 channel 的雏形。
2. 哲学家问题
文章的最后,回到了经典的哲学家问题。
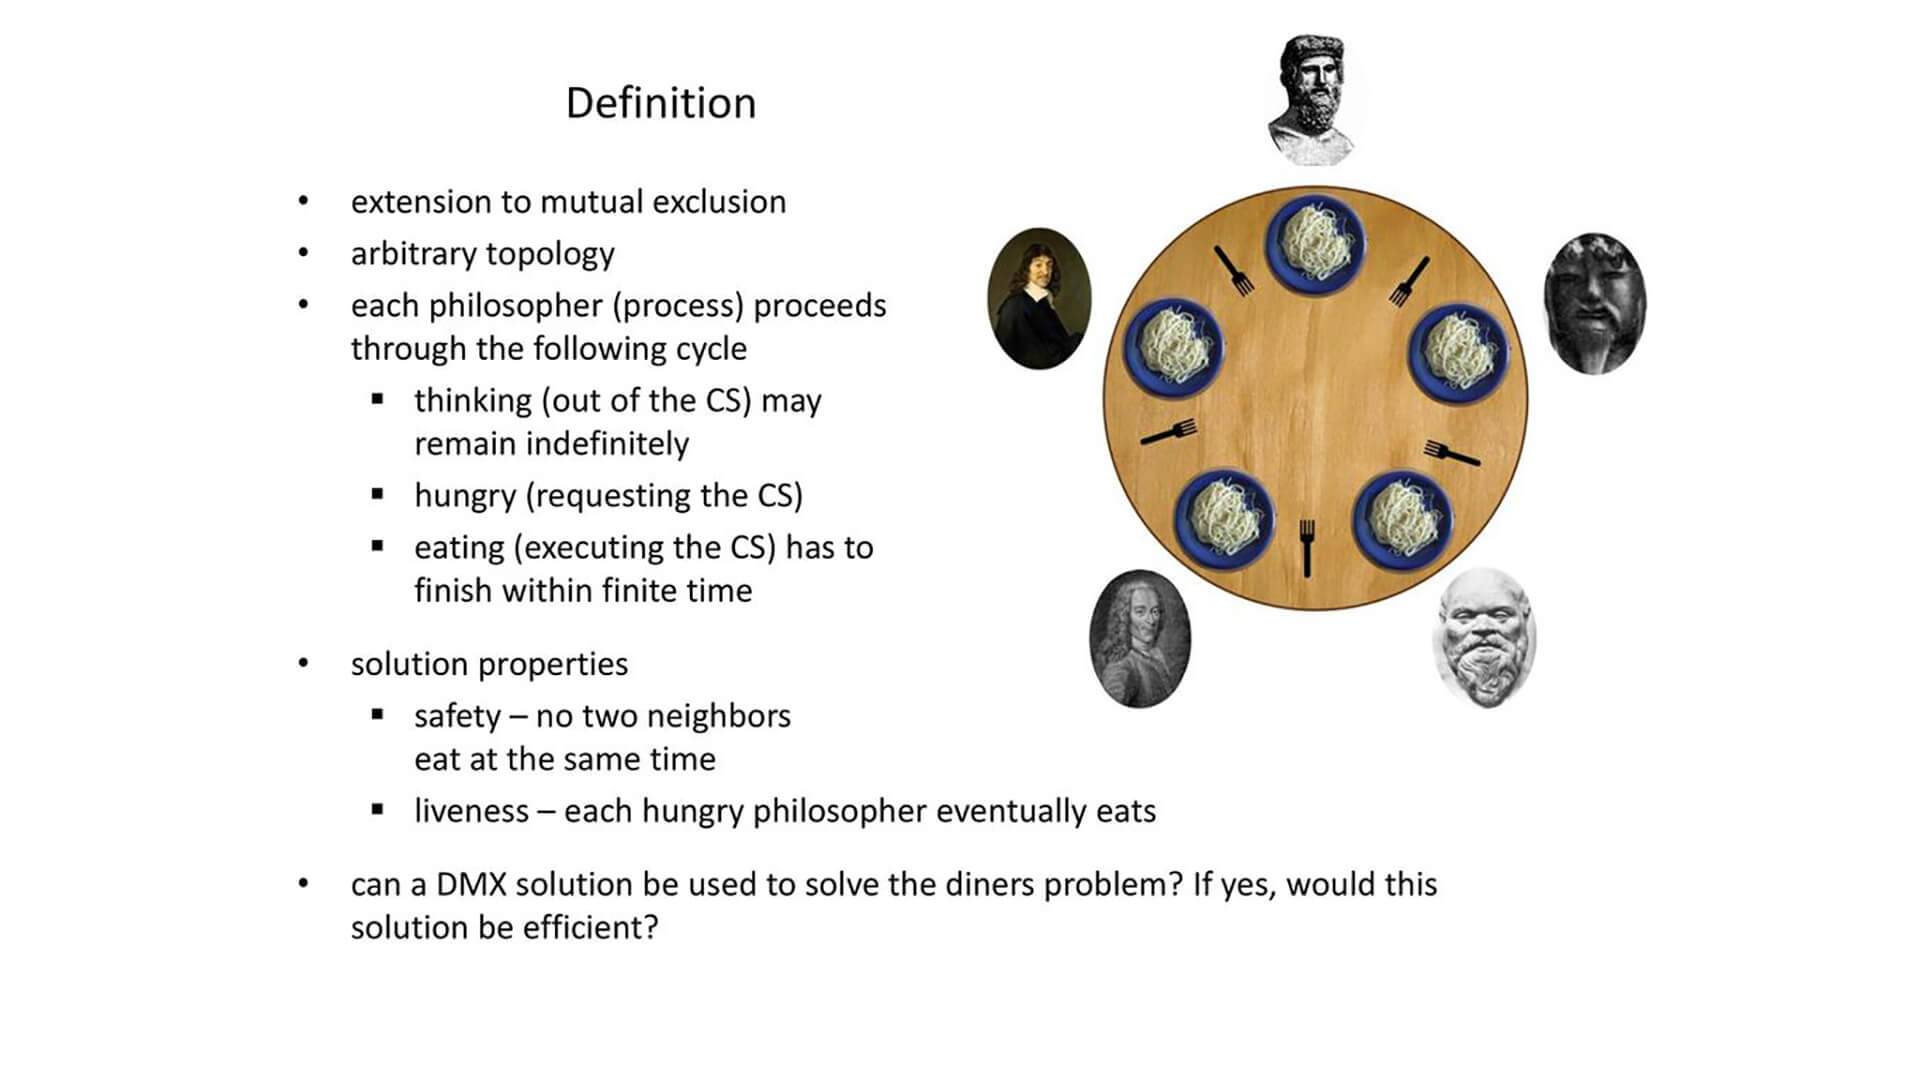
在哲学家问题中,Hoare 将 philosopher 的行为描述如下:
PHIL = *[... during ith lifetime ... --->, THINK; room!enter( ); fork(0!pickup( ); fork((/+ 1) rood 5)!pickup( ); EAT; fork(i)!putdown( ); fork((/+ 1) mod 5)!putdown( ); room!exit( ) ] 每个叉子由坐在两边的哲学家使用或者放下:
FORK = *[phil(0?pickup( )--* phil(0?putdown( ) 0phil((i - 1)rood 5)?pickup( ) --* phil((/- l) raod 5)?putdown( ) ] 整个哲学家在房间中的行为可以描述为:
ROOM = occupancy:integer; occupancy .--- 0; ,[(i:0..4)phil(0?enter ( ) --* occupancy .--- occupancy + l 11(i:0..4)phil(0?exit ( ) --~ occupancy .--- occupancy - l ] 决定如何向等待的进程分配资源的任务称为调度。Hoare 将调度分为两个事件:
- processes 请求资源
- 将资源分配给 processes
那么这个哲学家问题可以转换成 PHIL 和 FORK 这两个组件并发的过程:
[room::ROOM I [fork( i:0..4)::FORK I Iphil( i:0..4)::PHIL]. 从请求到授予资源的时间就是等待时间。在 CSP 中,有几种技术可以防止无限的等待时间。
- 限制资源使用并提高资源可用性。
- 先进先出(FIFO)将资源分配给等待时间最长的进程。
- 面包店算法Carnegie Melon. Bakery Algorithm
3. 缺陷
在确定性程序中,如果环境恒定,结果将是相同的。 由于并发基于非确定性,因此环境不会影响程序。给定所选的路径,程序则可以运行几次并收到不同的结果。为了确保并发程序的准确性,程序员必须能够在整体水平上考虑其程序的执行。
但是,尽管 Hoare 引入了正式的方法,但仍然缺少任何验证正确程序的证明方法。CSP 只能发现已知问题,而不能发现未知问题。虽然基于 CSP 的商业应用程序(例如ConAn)可以检测到错误的存在,但是不能检测没有错误的情况,(无法验证正确性)。尽管 CSP 为我们提供了编写可以避免常见并发错误的程序的工具,但是正确程序的证明仍然是 CSP 中尚未解决的领域。
4. 未来
CSP 在生物学和化学领域具有巨大的潜力,可以对自然界中的复杂系统进行建模。 由于该行业面临许多现存的逻辑问题,因此尚未在行业中广泛使用。在关于 CSP 开发 25 周年的会议上,Hoare 指出,尽管有许多由 Microsoft 资助的研究项目,但比尔·盖茨(Bill Gates)忽略了 Microsoft 何时能够将 CSP 的研究成果商业化的问题。
Hoare 提醒他的听众,动态过程领域仍然需要更多的研究。当前,计算机科学界陷入了顺序思维的范式。随着 Hoare 建立正式的并发方法的基础,科学界已做好准备成为并行编程的下一个革命。
5. Go 并发哲学
在 Go 语言发布之前,很少有语言从底层为并发原语提供支持。大多数语言还是支持共享和内存访问同步到 CSP 的消息传递方法。Go 语言算是最早将 CSP 原则纳入其核心的语言之一。内存访问同步的方式并不是不好,只是在高并发的场景下有时候难以正确的使用,特别是在超大型,巨型的程序中。基于此,并发能力被认为是 Go 语言天生优势之一。追其根本,还是因为 Go 基于 CSP 创造出来的一系列易读,方便编写的并发原语。
Go 语言除了 CSP 并发原语以外,还支持通过内存访问同步。sync 与其他包中的结构体与方法可以让开发者创建 WaitGroup,互斥锁和读写锁,cond,once,sync.Pool。在 Go 语言的官方 FAQ 中,描述了如何选择这些并发原语:
为了尊重 mutex,sync 包实现了 mutex,但是我们希望 Go 语言的编程风格将会激励人们尝试更高等级的技巧。尤其是考虑构建你的程序,以便一次只有一个 goroutine 负责某个特定的数据。
不要通过共享内存进行通信。建议,通过通信来共享内存。(Do not communicate by sharing memory; instead, share memory by communicating)这是 Go 语言并发的哲学座右铭。相对于使用 sync.Mutex 这样的并发原语。虽然大多数锁的问题可以通过 channel 或者传统的锁两种方式之一解决,但是 Go 语言核心团队更加推荐使用 CSP 的方式。
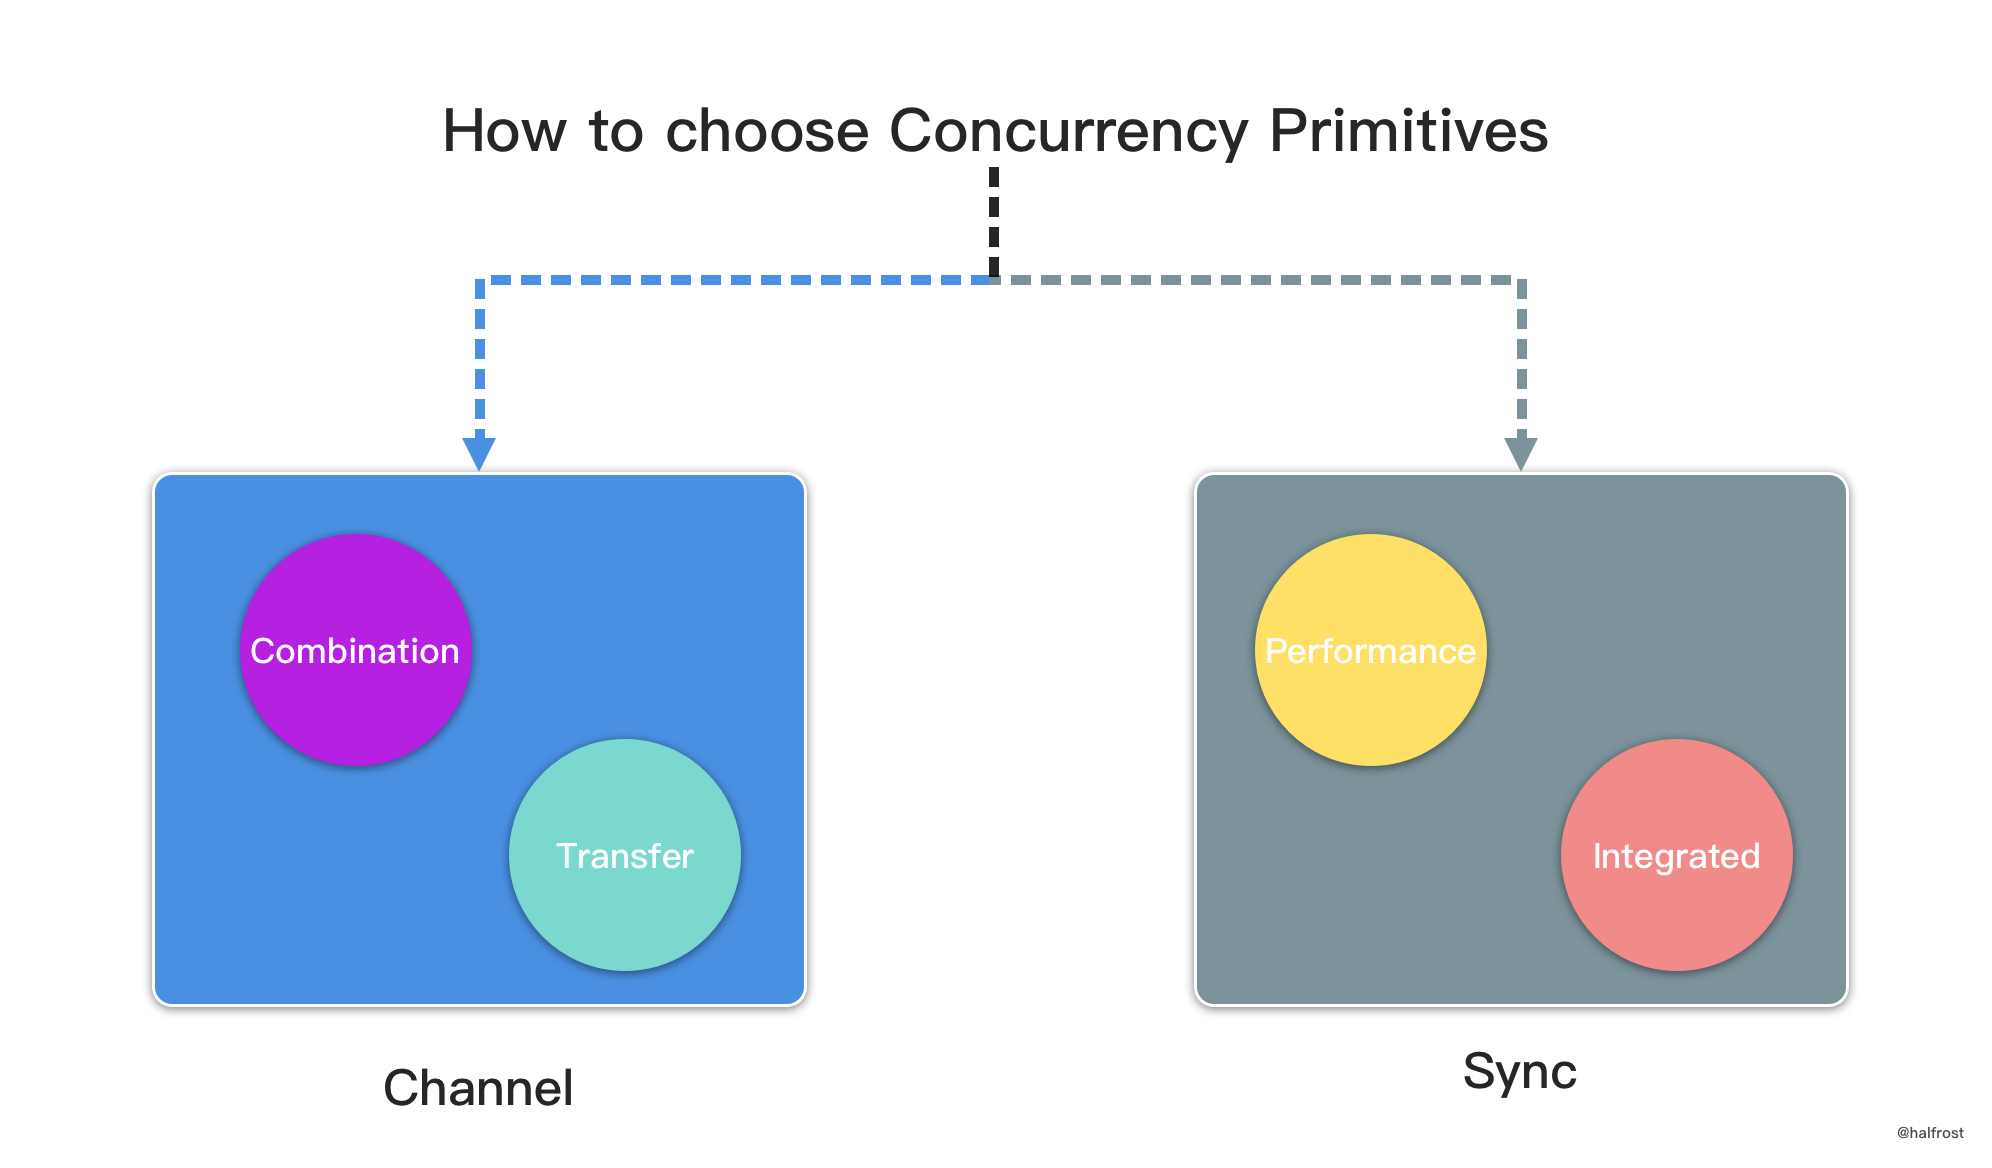
关于如何选择并发原语的问题,本文作为第一篇文章必然需要解释清楚。Go 中的并发原语主要分为 2 大类,一个是 sync 包里面的,另一个是 channel。sync 包里面主要是 WaitGroup,互斥锁和读写锁,cond,once,sync.Pool 这一类。在 2 种情况下推荐使用 sync 包:
- 对性能要求极高的临界区
- 保护某个结构内部状态和完整性
关于保护某个结构内部的状态和完整性。例如 Go 源码中如下代码:
var sum struct { sync.Mutex i int } //export Add func Add(x int) { defer func() { recover() }() sum.Lock() sum.i += x sum.Unlock() var p *int *p = 2 } sum 这个结构体不想将内部的变量暴露在结构体之外,所以使用 sync.Mutex 来保护线程安全。
相对于 sync 包,channel 也有 2 种情况:
- 输出数据给其他使用方
- 组合多个逻辑
输出数据给其他使用方的目的是转移数据的使用权。并发安全的实质是保证同时只有一个并发上下文拥有数据的所有权。channel 可以很方便的将数据所有权转给其他使用方。另一个优势是组合型。如果使用 sync 里面的锁,想实现组合多个逻辑并且保证并发安全,是比较困难的。但是使用 channel + select 实现组合逻辑实在太方便了。以上就是 CSP 的基本概念和何时选择 channel 的时机。下一章从 channel 基本数据结构开始详细分析 channel 底层源码实现。
以下代码基于 Go 1.16
二. 基本数据结构
channel 的底层源码和相关实现在 src/runtime/chan.go 中。
type hchan struct { qcount uint // 队列中所有数据总数 dataqsiz uint // 环形队列的 size buf unsafe.Pointer // 指向 dataqsiz 长度的数组 elemsize uint16 // 元素大小 closed uint32 elemtype *_type // 元素类型 sendx uint // 已发送的元素在环形队列中的位置 recvx uint // 已接收的元素在环形队列中的位置 recvq waitq // 接收者的等待队列 sendq waitq // 发送者的等待队列 lock mutex } lock 锁保护 hchan 中的所有字段,以及此通道上被阻塞的 sudogs 中的多个字段。持有 lock 的时候,禁止更改另一个 G 的状态(特别是不要使 G 状态变成ready),因为这会因为堆栈 shrinking 而发生死锁。
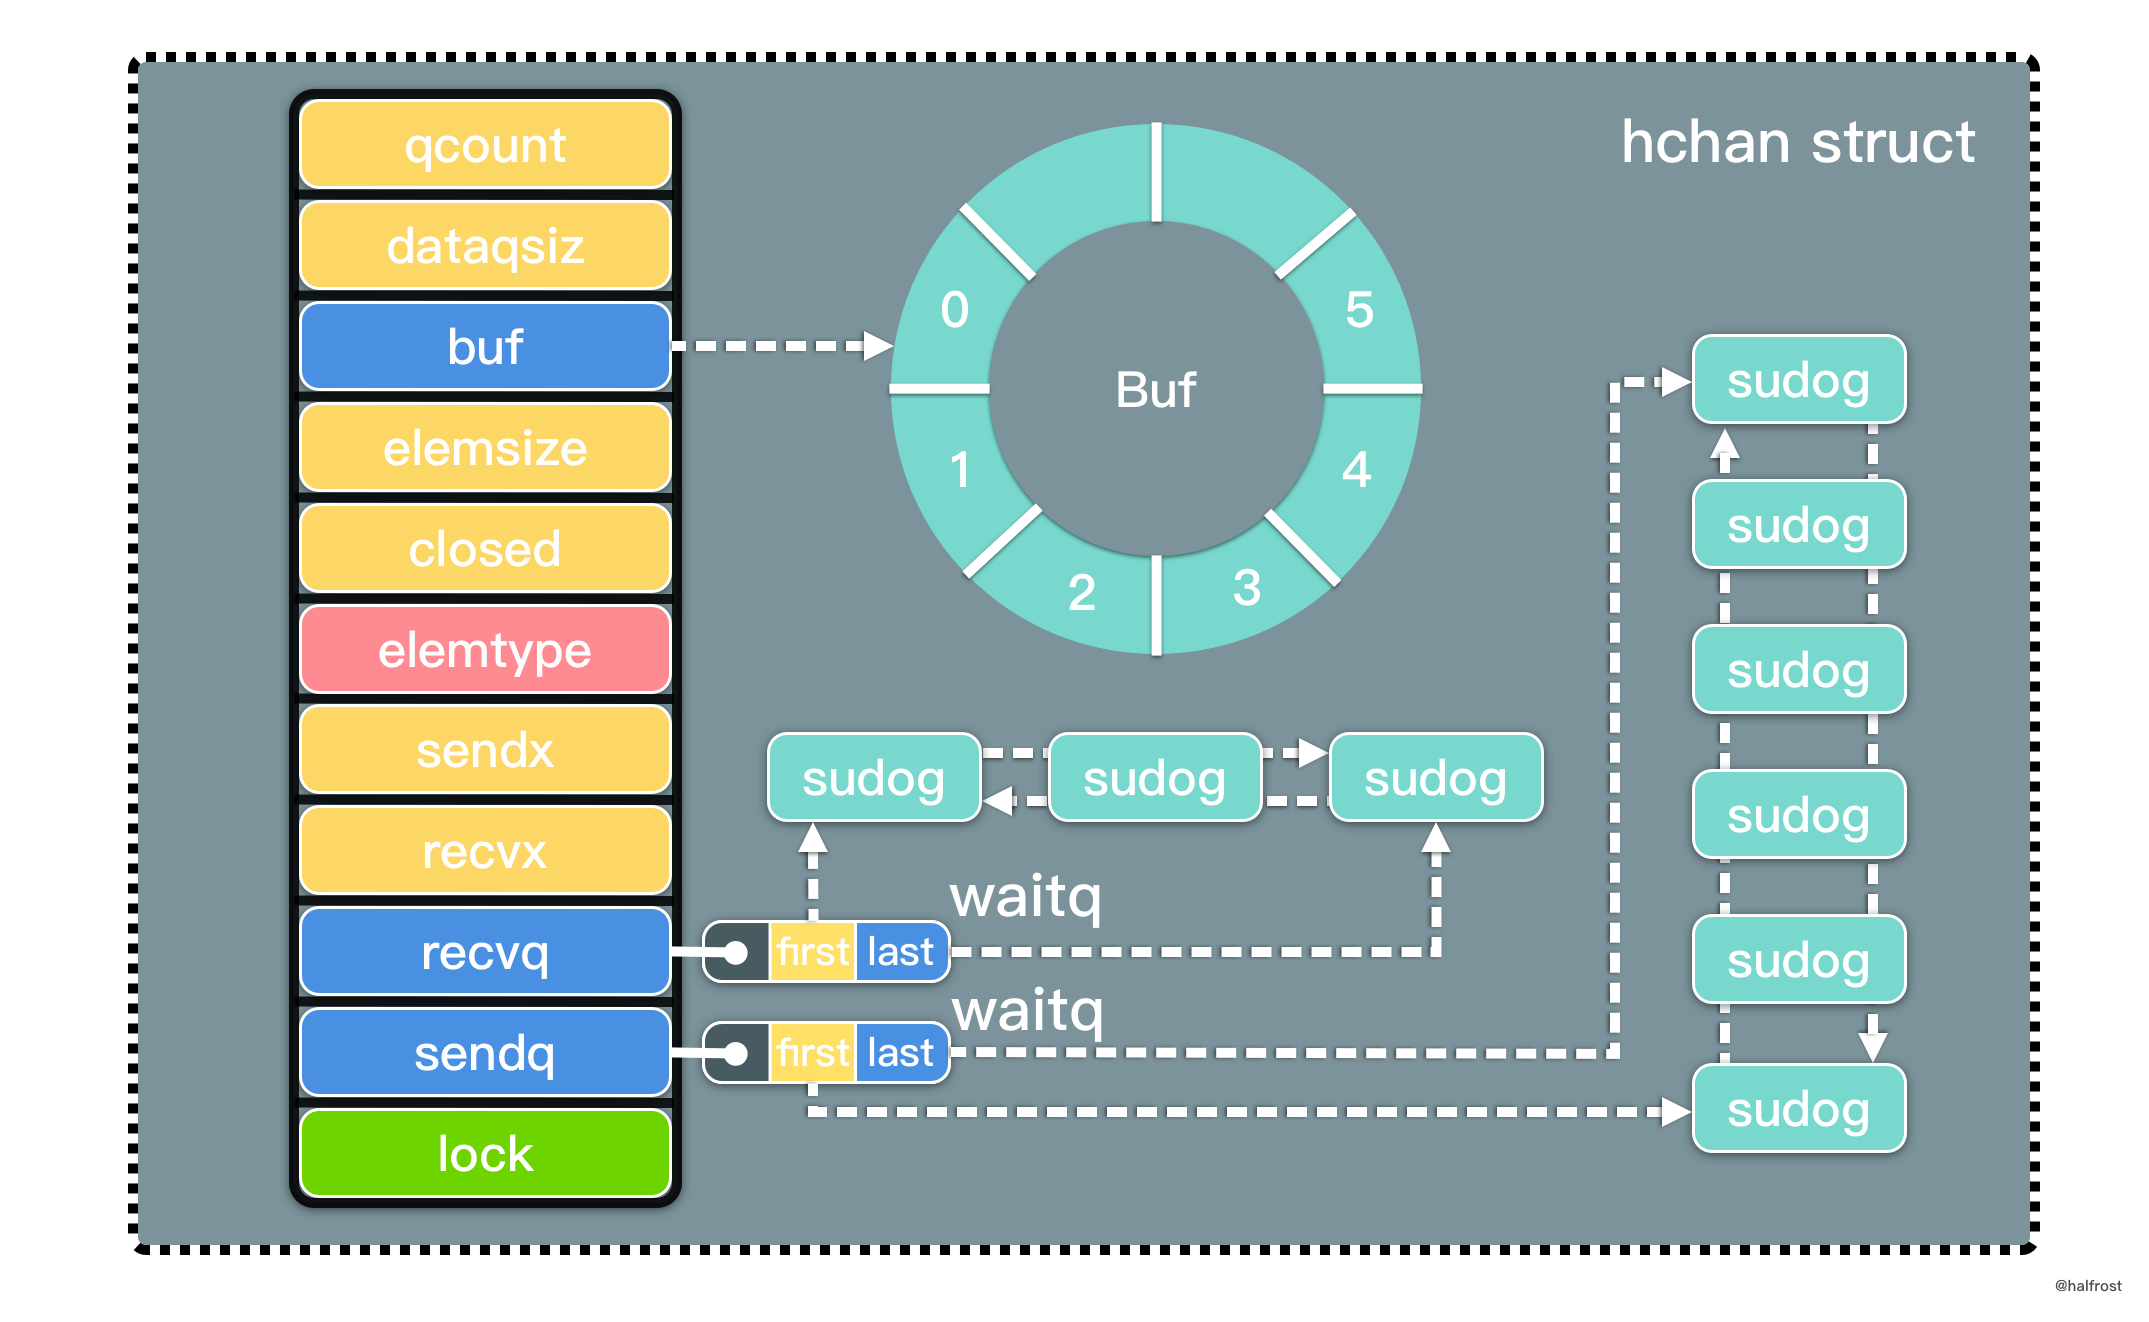
recvq 和 sendq 是等待队列,waitq 是一个双向链表:
type waitq struct { first *sudog last *sudog } channel 最核心的数据结构是 sudog。sudog 代表了一个在等待队列中的 g。sudog 是 Go 中非常重要的数据结构,因为 g 与同步对象关系是多对多的。一个 g 可以出现在许多等待队列上,因此一个 g 可能有很多sudog。并且多个 g 可能正在等待同一个同步对象,因此一个对象可能有许多 sudog。sudog 是从特殊池中分配出来的。使用 acquireSudog 和 releaseSudog 分配和释放它们。
type sudog struct { g *g next *sudog prev *sudog elem unsafe.Pointer // 指向数据 (可能指向栈) acquiretime int64 releasetime int64 ticket uint32 isSelect bool success bool parent *sudog // semaRoot 二叉树 waitlink *sudog // g.waiting 列表或者 semaRoot waittail *sudog // semaRoot c *hchan // channel } sudog 中所有字段都受 hchan.lock 保护。acquiretime、releasetime、ticket 这三个字段永远不会被同时访问。对 channel 来说,waitlink 只由 g 使用。对 semaphores 来说,只有在持有 semaRoot 锁的时候才能访问这三个字段。isSelect 表示 g 是否被选择,g.selectDone 必须进行 CAS 才能在被唤醒的竞争中胜出。success 表示 channel c 上的通信是否成功。如果 goroutine 在 channel c 上传了一个值而被唤醒,则为 true;如果因为 c 关闭而被唤醒,则为 false。
三. 创建 Channel
创建 channel 常见代码:
ch := make(chan int) 编译器编译上述代码,在检查 ir 节点时,根据节点 op 不同类型,进行不同的检查,如下源码:
func walkExpr1(n ir.Node, init *ir.Nodes) ir.Node { switch n.Op() { default: ir.Dump("walk", n) base.Fatalf("walkExpr: switch 1 unknown op %+v", n.Op()) panic("unreachable") case ir.OMAKECHAN: n := n.(*ir.MakeExpr) return walkMakeChan(n, init) ...... } 编译器会检查每一种类型,walkExpr1() 的实现就是一个 switch-case,函数末尾没有 return,因为每一个 case 都会 return 或者返回 panic。这样做是为了与存在类型断言的情况中返回的内容做区分。walk 具体处理 OMAKECHAN 类型节点的逻辑如下:
func walkMakeChan(n *ir.MakeExpr, init *ir.Nodes) ir.Node { size := n.Len fnname := "makechan64" argtype := types.Types[types.TINT64] if size.Type().IsKind(types.TIDEAL) || size.Type().Size() <= types.Types[types.TUINT].Size() { fnname = "makechan" argtype = types.Types[types.TINT] } return mkcall1(chanfn(fnname, 1, n.Type()), n.Type(), init, reflectdata.TypePtr(n.Type()), typecheck.Conv(size, argtype)) } 上述代码默认调用 makechan64() 函数。类型检查时如果 TIDEAL 大小在 int 范围内。将 TUINT 或 TUINTPTR 转换为 TINT 时出现大小溢出的情况,将在运行时在 makechan 中进行检查。如果在 make 函数中传入的 channel size 大小在 int 范围内,推荐使用 makechan()。因为 makechan() 在 32 位的平台上更快,用的内存更少。
makechan64() 和 makechan() 函数方法原型如下:
func makechan64(chanType *byte, size int64) (hchan chan any) func makechan(chanType *byte, size int) (hchan chan any) makechan64() 方法只是判断一下传入的入参 size 是否还在 int 范围之内:
func makechan64(t *chantype, size int64) *hchan { if int64(int(size)) != size { panic(plainError("makechan: size out of range")) } return makechan(t, int(size)) } 创建 channel 的主要实现在 makechan() 函数中:
func makechan(t *chantype, size int) *hchan { elem := t.elem // 编译器检查数据项大小不能超过 64KB if elem.size >= 1<<16 { throw("makechan: invalid channel element type") } // 检查对齐是否正确 if hchanSize%maxAlign != 0 || elem.align > maxAlign { throw("makechan: bad alignment") } // 缓冲区大小检查,判断是否溢出 mem, overflow := math.MulUintptr(elem.size, uintptr(size)) if overflow || mem > maxAlloc-hchanSize || size < 0 { panic(plainError("makechan: size out of range")) } var c *hchan switch { case mem == 0: // 队列或者元素大小为 zero 时 c = (*hchan)(mallocgc(hchanSize, nil, true)) // Race 竞争检查利用这个地址来进行同步操作 c.buf = c.raceaddr() case elem.ptrdata == 0: // 元素不包含指针时。一次分配 hchan 和 buf 的内存。 c = (*hchan)(mallocgc(hchanSize+mem, nil, true)) c.buf = add(unsafe.Pointer(c), hchanSize) default: // 元素包含指针时 c = new(hchan) c.buf = mallocgc(mem, elem, true) } // 设置属性 c.elemsize = uint16(elem.size) c.elemtype = elem c.dataqsiz = uint(size) lockInit(&c.lock, lockRankHchan) if debugChan { print("makechan: chan=", c, "; elemsize=", elem.size, "; dataqsiz=", size, "\n") } return c } 上面这段 makechan() 代码主要目的是生成 *hchan 对象。重点关注 switch-case 中的 3 种情况:
- 当队列或者元素大小为 0 时,调用 mallocgc() 在堆上为 channel 开辟一段大小为 hchanSize 的内存空间。
- 当元素类型不是指针类型时,调用 mallocgc() 在堆上开辟为 channel 和底层 buf 缓冲区数组开辟一段大小为 hchanSize + mem 连续的内存空间。
- 默认情况元素类型中有指针类型,调用 mallocgc() 在堆上分别为 channel 和 buf 缓冲区分配内存。
完成第一步的内存分配之后,再就是 hchan 数据结构其他字段的初始化和 lock 的初始化。值得说明的一点是,当存储在 buf 中的元素不包含指针时,Hchan 中也不包含 GC 关心的指针。buf 指向一段相同元素类型的内存,elemtype 固定不变。SudoG 是从它们自己的线程中引用的,因此垃圾回收的时候无法回收它们。受到垃圾回收器的限制,指针类型的缓冲 buf 需要单独分配内存。官方在这里加了一个 TODO,垃圾回收的时候这段代码逻辑需要重新考虑。
就是因为 channel 的创建全部调用的 mallocgc(),在堆上开辟的内存空间,channel 本身会被 GC 自动回收。有了这一性质,所以才有了下文关闭 channel 中优雅关闭的方法。
四. 发送数据
向 channel 中发送数据常见代码:
ch <- 1 编译器编译上述代码,在检查 ir 节点时,根据节点 op 不同类型,进行不同的检查,如下源码:
func walkExpr1(n ir.Node, init *ir.Nodes) ir.Node { switch n.Op() { default: ir.Dump("walk", n) base.Fatalf("walkExpr: switch 1 unknown op %+v", n.Op()) panic("unreachable") case ir.OSEND: n := n.(*ir.SendStmt) return walkSend(n, init) ...... } walkExpr1() 函数在创建 channel 提到了,这里不再赘述。操作类型是 OSEND,对应调用 walkSend() 函数:
func walkSend(n *ir.SendStmt, init *ir.Nodes) ir.Node { n1 := n.Value n1 = typecheck.AssignConv(n1, n.Chan.Type().Elem(), "chan send") n1 = walkExpr(n1, init) n1 = typecheck.NodAddr(n1) return mkcall1(chanfn("chansend1", 2, n.Chan.Type()), nil, init, n.Chan, n1) } // entry point for c <- x from compiled code //go:nosplit func chansend1(c *hchan, elem unsafe.Pointer) { chansend(c, elem, true, getcallerpc()) } walkSend() 函数中主要逻辑调用了 chansend1(),而 chansend1() 只是 chansend() 的“外壳”。所以 channel 发送数据的核心实现在 chansend() 中。根据 channel 的阻塞和唤醒,又可以分为 2 部分逻辑代码。接下来笔者讲 chansend() 代码拆成 4 部分详细分析。
1. 异常检查
chansend() 函数一开始先进行异常检查:
func chansend(c *hchan, ep unsafe.Pointer, block bool, callerpc uintptr) bool { // 判断 channel 是否为 nil if c == nil { if !block { return false } gopark(nil, nil, waitReasonChanSendNilChan, traceEvGoStop, 2) throw("unreachable") } if debugChan { print("chansend: chan=", c, "\n") } if raceenabled { racereadpc(c.raceaddr(), callerpc, funcPC(chansend)) } // 简易快速的检查 if !block && c.closed == 0 && full(c) { return false } ...... } chansend() 一上来对 channel 进行检查,如果被 GC 回收了会变为 nil。朝一个为 nil 的 channel 发送数据会发生阻塞。gopark 会引发以 waitReasonChanSendNilChan 为原因的休眠,并抛出 unreachable 的 fatal error。当 channel 不为 nil,再开始检查在没有获取锁的情况下会导致发送失败的非阻塞操作。
当 channel 不为 nil,并且 channel 没有 close 时,还需要检查此时 channel 是否做好发送的准备,即判断 full(c)
func full(c *hchan) bool { if c.dataqsiz == 0 { // 假设指针读取是近似原子性的 return c.recvq.first == nil } // 假设读取 uint 是近似原子性的 return c.qcount == c.dataqsiz } full() 方法作用是判断在 channel 上发送是否会阻塞(即通道已满)。它读取单个字节大小的可变状态(recvq.first 和 qcount),尽管答案可能在一瞬间是 true,但在调用函数收到返回值时,正确的结果可能发生了更改。值得注意的是 dataqsiz 字段,它在创建完 channel 以后是不可变的,因此它可以安全的在任意时刻读取。
回到 chansend() 异常检查中。一个已经 close 的 channel 是不可能从“准备发送”的状态变为“未准备好发送”的状态。所以在检查完 channel 是否 close 以后,就算 channel close 了,也不影响此处检查的结果。可能有读者疑惑,“能不能把检查顺序倒一倒?先检查是否 full(),再检查是否 close?”。这样倒过来确实能保证检查 full() 的时候,channel 没有 close。但是这种做法也没有实质性的改变。channel 依旧可以在检查完 close 以后再关闭。其实我们依赖的是 chanrecv() 和 closechan() 这两个方法在锁释放后,它们更新这个线程 c.close 和 full() 的结果视图。
2. 同步发送
channel 异常状态检查以后,接下来的代码是发送的逻辑。
func chansend(c *hchan, ep unsafe.Pointer, block bool, callerpc uintptr) bool { ...... lock(&c.lock) if c.closed != 0 { unlock(&c.lock) panic(plainError("send on closed channel")) } if sg := c.recvq.dequeue(); sg != nil { send(c, sg, ep, func() { unlock(&c.lock) }, 3) return true } ...... } 在发送之前,先上锁,保证线程安全。并再一次检查 channel 是否关闭。如果关闭则抛出 panic。加锁成功并且 channel 未关闭,开始发送。如果有正在阻塞等待的接收方,通过 dequeue() 取出头部第一个非空的 sudog,调用 send() 函数:
func send(c *hchan, sg *sudog, ep unsafe.Pointer, unlockf func(), skip int) { if sg.elem != nil { sendDirect(c.elemtype, sg, ep) sg.elem = nil } gp := sg.g unlockf() gp.param = unsafe.Pointer(sg) sg.success = true if sg.releasetime != 0 { sg.releasetime = cputicks() } goready(gp, skip+1) } send() 函数主要完成了 2 件事:
-
- 调用 sendDirect() 函数将数据拷贝到了接收变量的内存地址上
-
- 调用 goready() 将等待接收的阻塞 goroutine 的状态从 Gwaiting 或者 Gscanwaiting 改变成 Grunnable。下一轮调度时会唤醒这个接收的 goroutine。
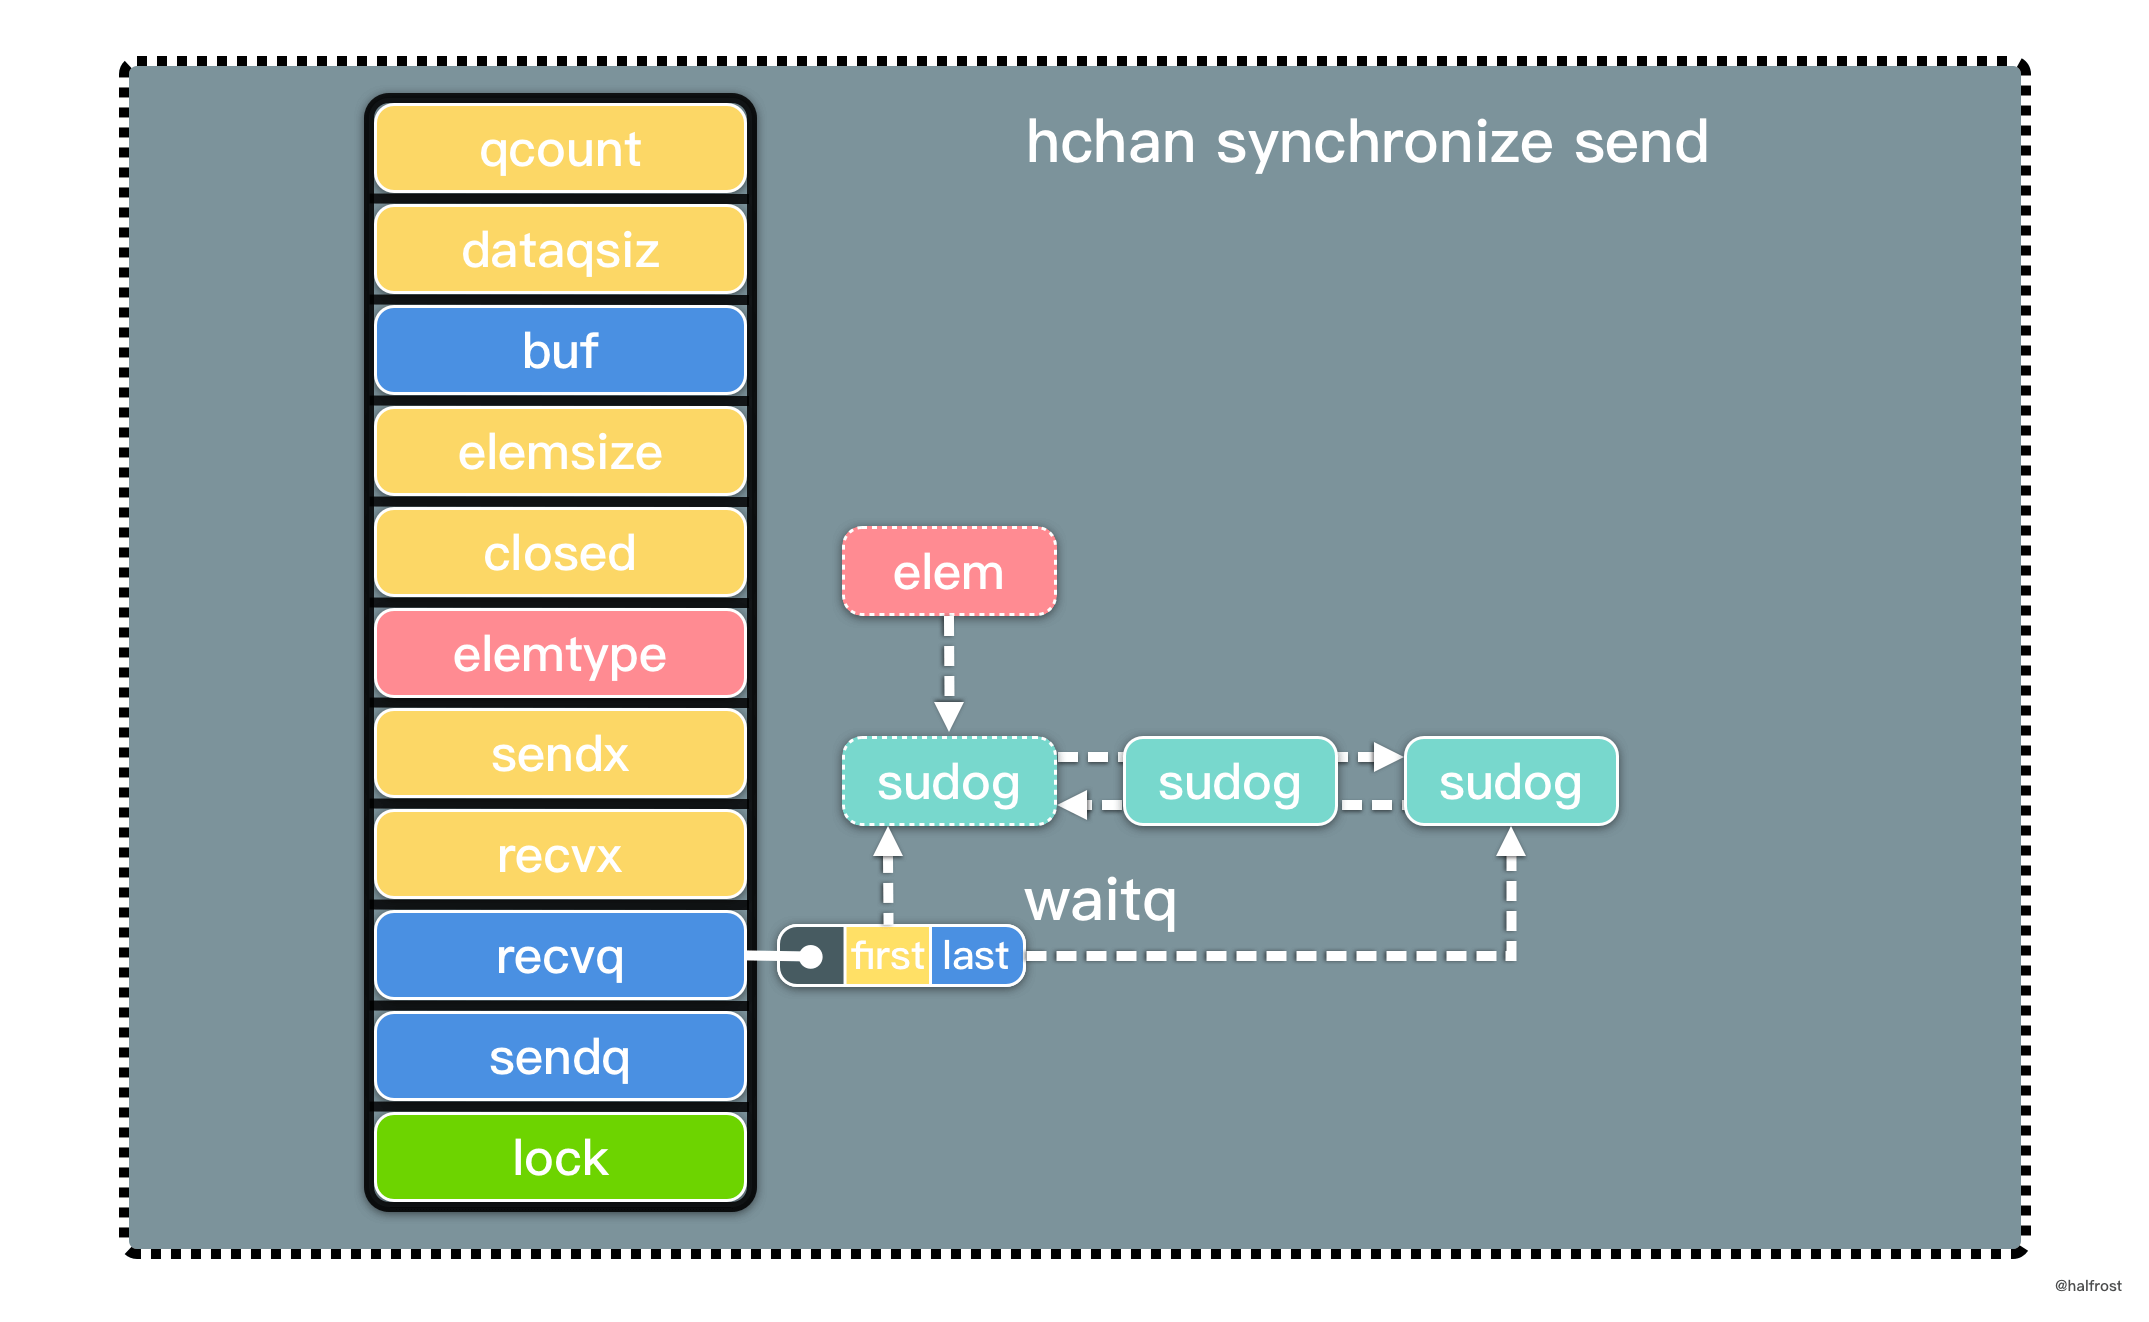
这里重点说说 goready() 的实现。理解了它的源码,就能明白为什么往 channel 中发送数据并非立即可以从接收方获取到。
func goready(gp *g, traceskip int) { systemstack(func() { ready(gp, traceskip, true) }) } func ready(gp *g, traceskip int, next bool) { ...... casgstatus(gp, _Gwaiting, _Grunnable) runqput(_g_.m.p.ptr(), gp, next) wakep() releasem(mp) } 在 runqput() 函数的作用是把 g 绑定到本地可运行的队列中。此处 next 传入的是 true,将 g 插入到 runnext 插槽中,等待下次调度便立即运行。因为这一点导致了虽然 goroutine 保证了线程安全,但是在读取数据方面比数组慢了几百纳秒。
| Read | Channel | Slice |
|---|---|---|
| Time | x * 100 * nanosecond | 0 |
| Thread safe | Yes | No |
所以在写测试用例的某些时候,需要考虑到这个微弱的延迟,可以适当加 sleep()。再比如刷 LeetCode 题目的时候,并非无脑使用 goroutine 就能带来 runtime 的提升,例如

