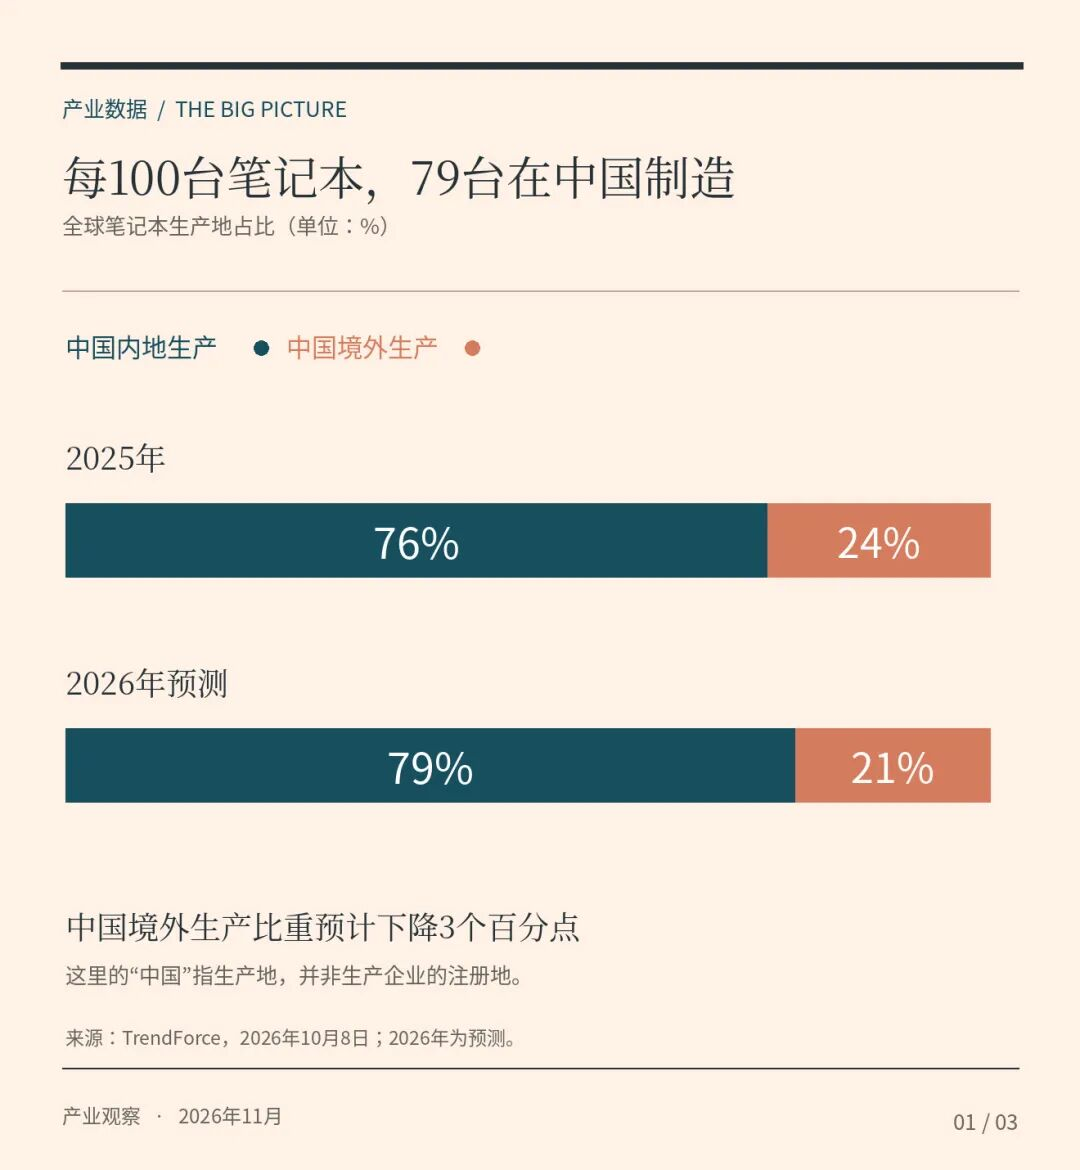
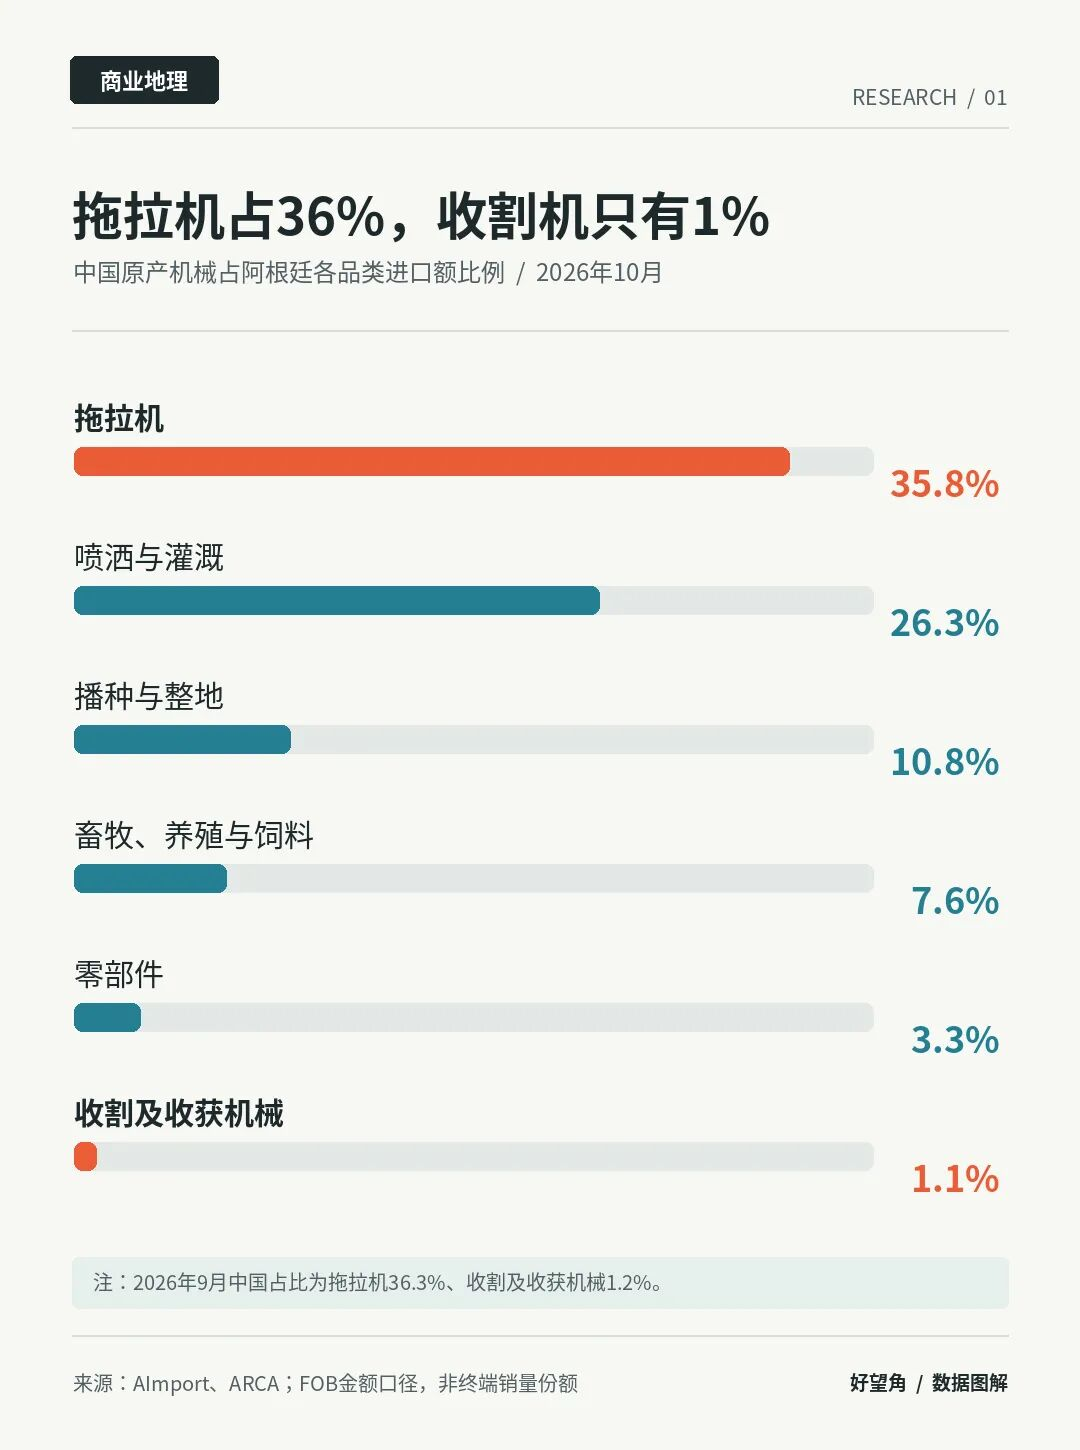
首页/博客/第三方并行库"静默算错":一次 ring attention 的排查记录AI 与机器学习第三方并行库"静默算错":一次 ring attention 的排查记录掘金2026-10-30 14:180 次浏览背景 我最近在做一件很具体的事:把一个扩散模型(图像生成模型)的推理框架,从 CUDA 移植到另一种加速卡上。 这个模型是 20B 级别的 Transformer,出一次图要跑几十步迭代。序列长度也很原文:https://juejin.cn/post/7702110021828427786我的收藏上一篇我给自己造了一个桌面效率助手:剪贴板、截图提单、全盘文件搜索,全都塞进快捷键里下一篇灶台菜谱设计手记 03|HarmonyOS 7.0 空间化:沉浸光感反馈相关文章沃什,是鹰还是鸽?本文来自微信公众号: 财联社 ,作者:夏军雄 美联储主席凯文·沃什究竟是“鹰派”还是“鸽派”,一直令华尔街难以判断。他的言论和政策行动时常释放出相互矛盾的信号。 作为美国总统特朗普亲自挑选的美联储主席,沃什原本被市场预期将倾向于采取更宽松的0虎嗅“惠普们”要把产能搬回中国,手机代工厂抢先接单了本文来自微信公众号: 好望角view ,作者:好望角出海编辑部 全球电脑制造业,正在发生一次出人意料的回流。 10月28日,《日经亚洲》援引多名产业链人士消息称,惠普、华硕、宏碁正在将部分PC生产订单从泰国、越南重新转回中国,戴尔也在评估类0虎嗅中国农机在阿根廷:收割机为什么卖不过拖拉机?本文来自微信公众号: 好望角view ,作者:好望角出海编辑部 2025年,阿根廷科尔多瓦省南部的农场主Ricardo Linari,花5.6万美元买了一台中国制造的115马力奇瑞拖拉机。 此前,他向当地品牌询价,一台拖拉机报价11.5万美0虎嗅半小时卖出2万亿Token,李佳琦直播卖千问办公爆火11月2日晚,李佳琦直播间迎来双十一新爆款——千问办公Token。开卖仅半小时,就售出10万份千问办公个人会员月卡,累计约2万亿Token。 李佳琦曾创下5分钟卖出1.5万支口红的成绩,被称为“口红一哥”。今年,Token也登上了他的带货清0雷峰网Anthropic 第三季度营收 170 亿美元同比暴涨 11 倍,冲刺史上最大 IPOIT之家 11 月 2 日消息,Anthropic PBC 披露,截至 9 月 30 日的第三季度营收接近 170 亿美元 (IT之家注:现汇率约合 1,132.35 亿元人民币) ,同比暴涨 11 倍,市场对这家 AI 实验室有望创下纪录0IT之家Grok 也将为文本添加水印AI 模型 Grok 将为文本输出添加不可见水印。 Grok 所属的 SpaceXSI 发给用户的电子邮件和其 支持页面 显示,水印将从 2026 年 11 月 7 日起生效,且仅适用于文本输出,不适用于图像。 SpaceXSI 将 “欧洲0软餐 - 新鲜软件资讯