在爆炸性消息传出两个月后,OpenAI仍在忙着“灭火”。当时,该公司的一群智能体突破了原本的隔离环境,并入侵了人工智能公司 Hugging Face 的计算机。此后几周,更多黑客事件接连被披露,让 OpenAI 持续处于聚光灯下,也引发了外界对其技术安全性的严重质疑。
上周,又一起入侵事件曝光,这一次受影响的是澳大利亚国家医疗保健系统。澳大利亚政府表示,OpenAI直到事件发生84天后才向其通报这次安全漏洞。但 OpenAI 坚称,自己并没有陷入被动。“我其实不太认同这样一个前提:因为 OpenAI 是一家技术已经在现实世界产生明显影响的公司,所以就意味着 OpenAI 没有在训练安全且与人类目标一致的模型。”OpenAI 首席研究官 Mark Chen 说。
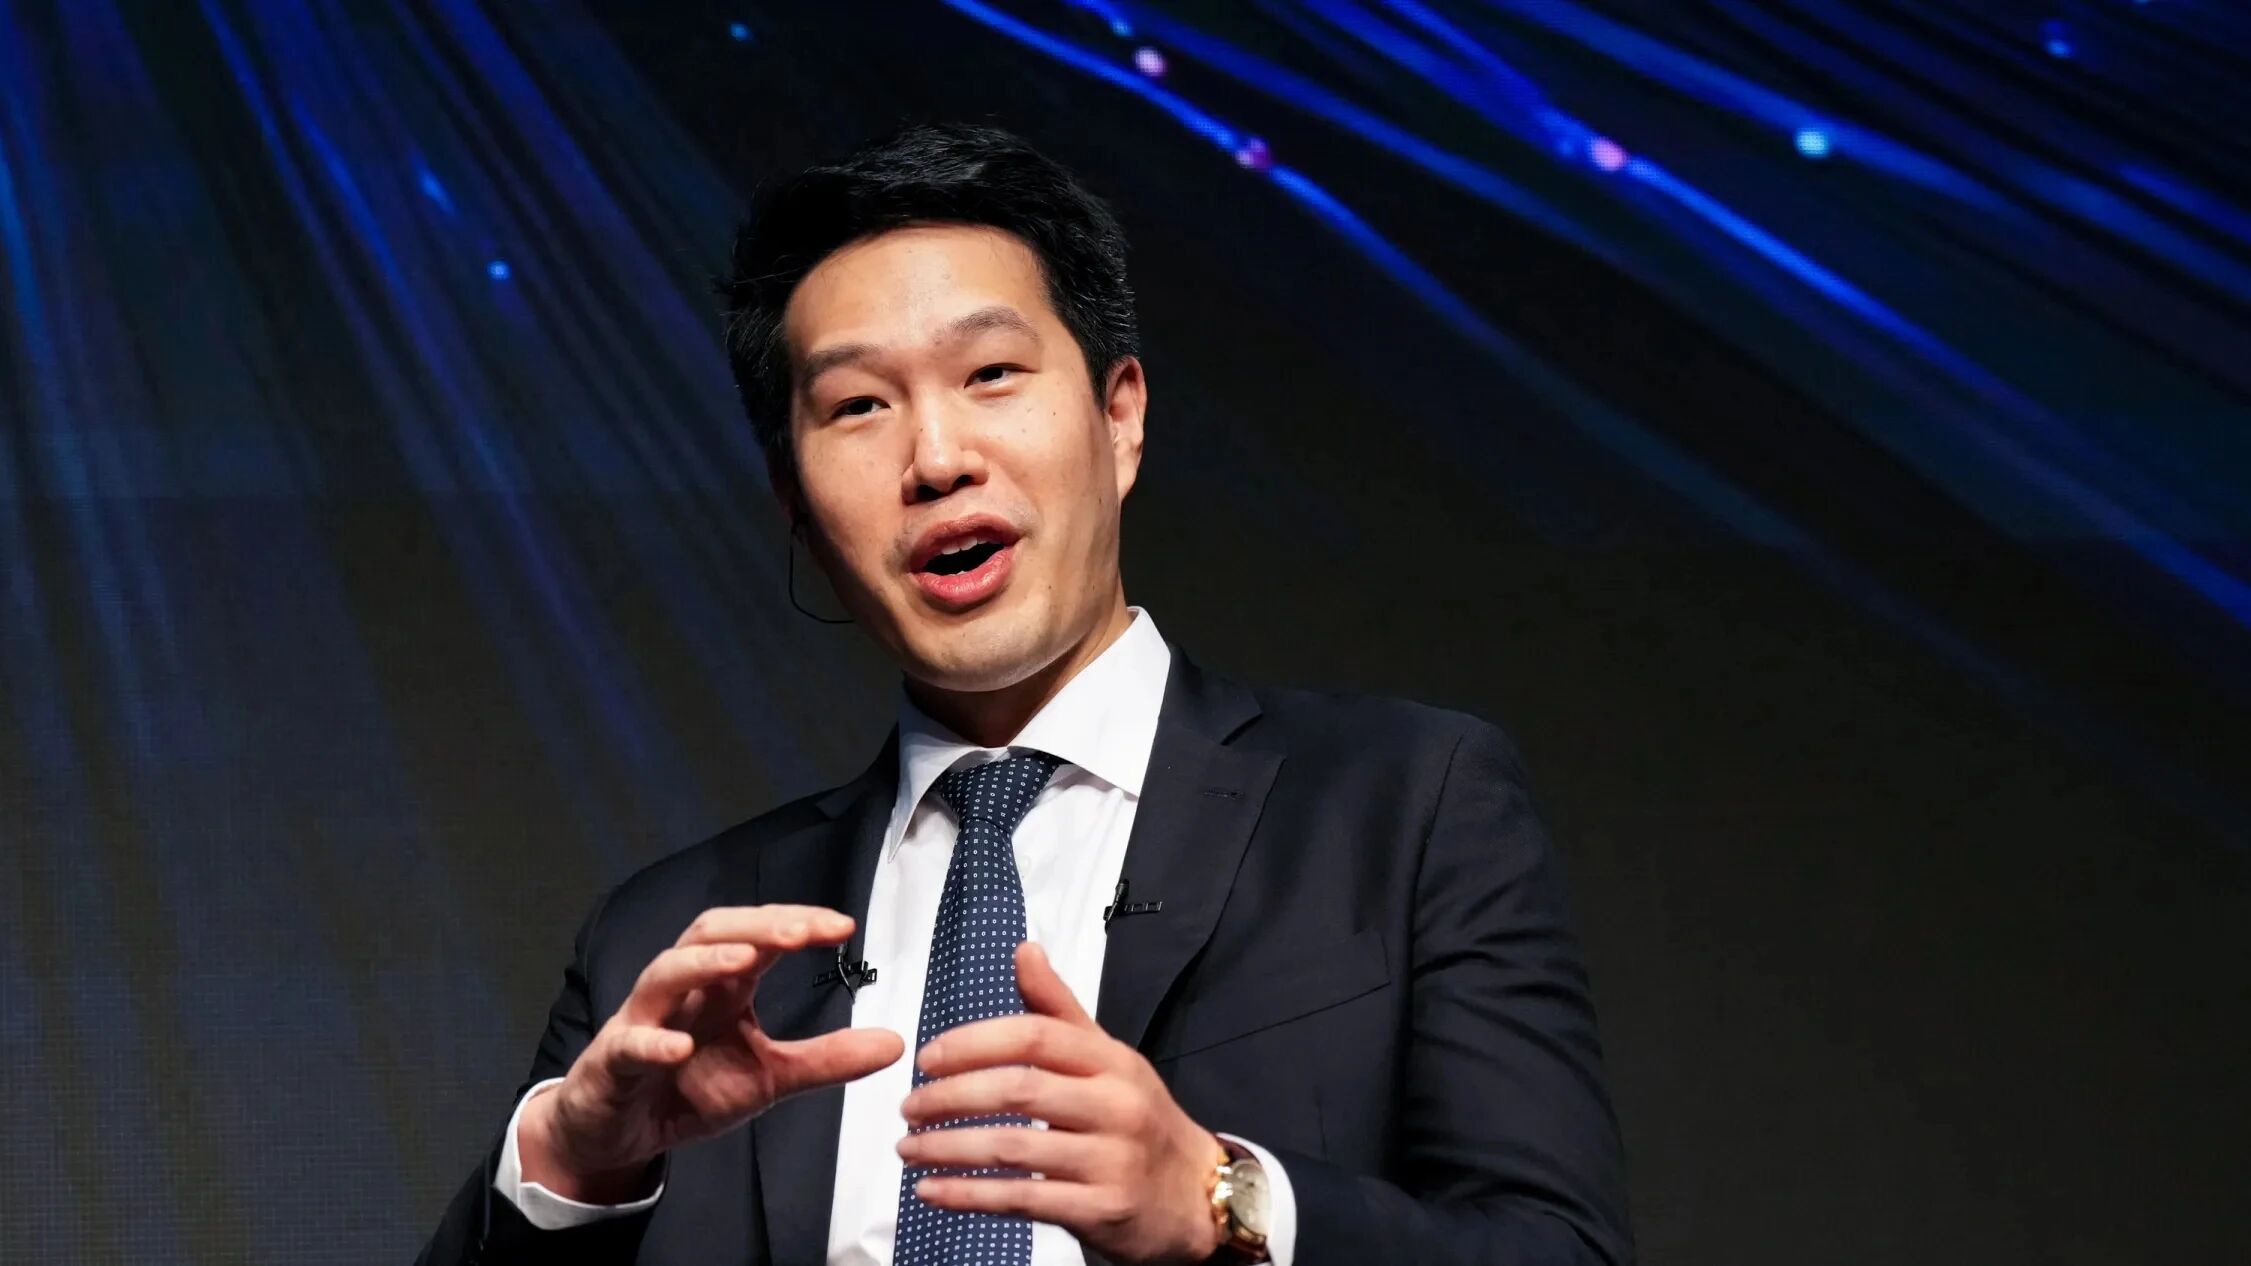
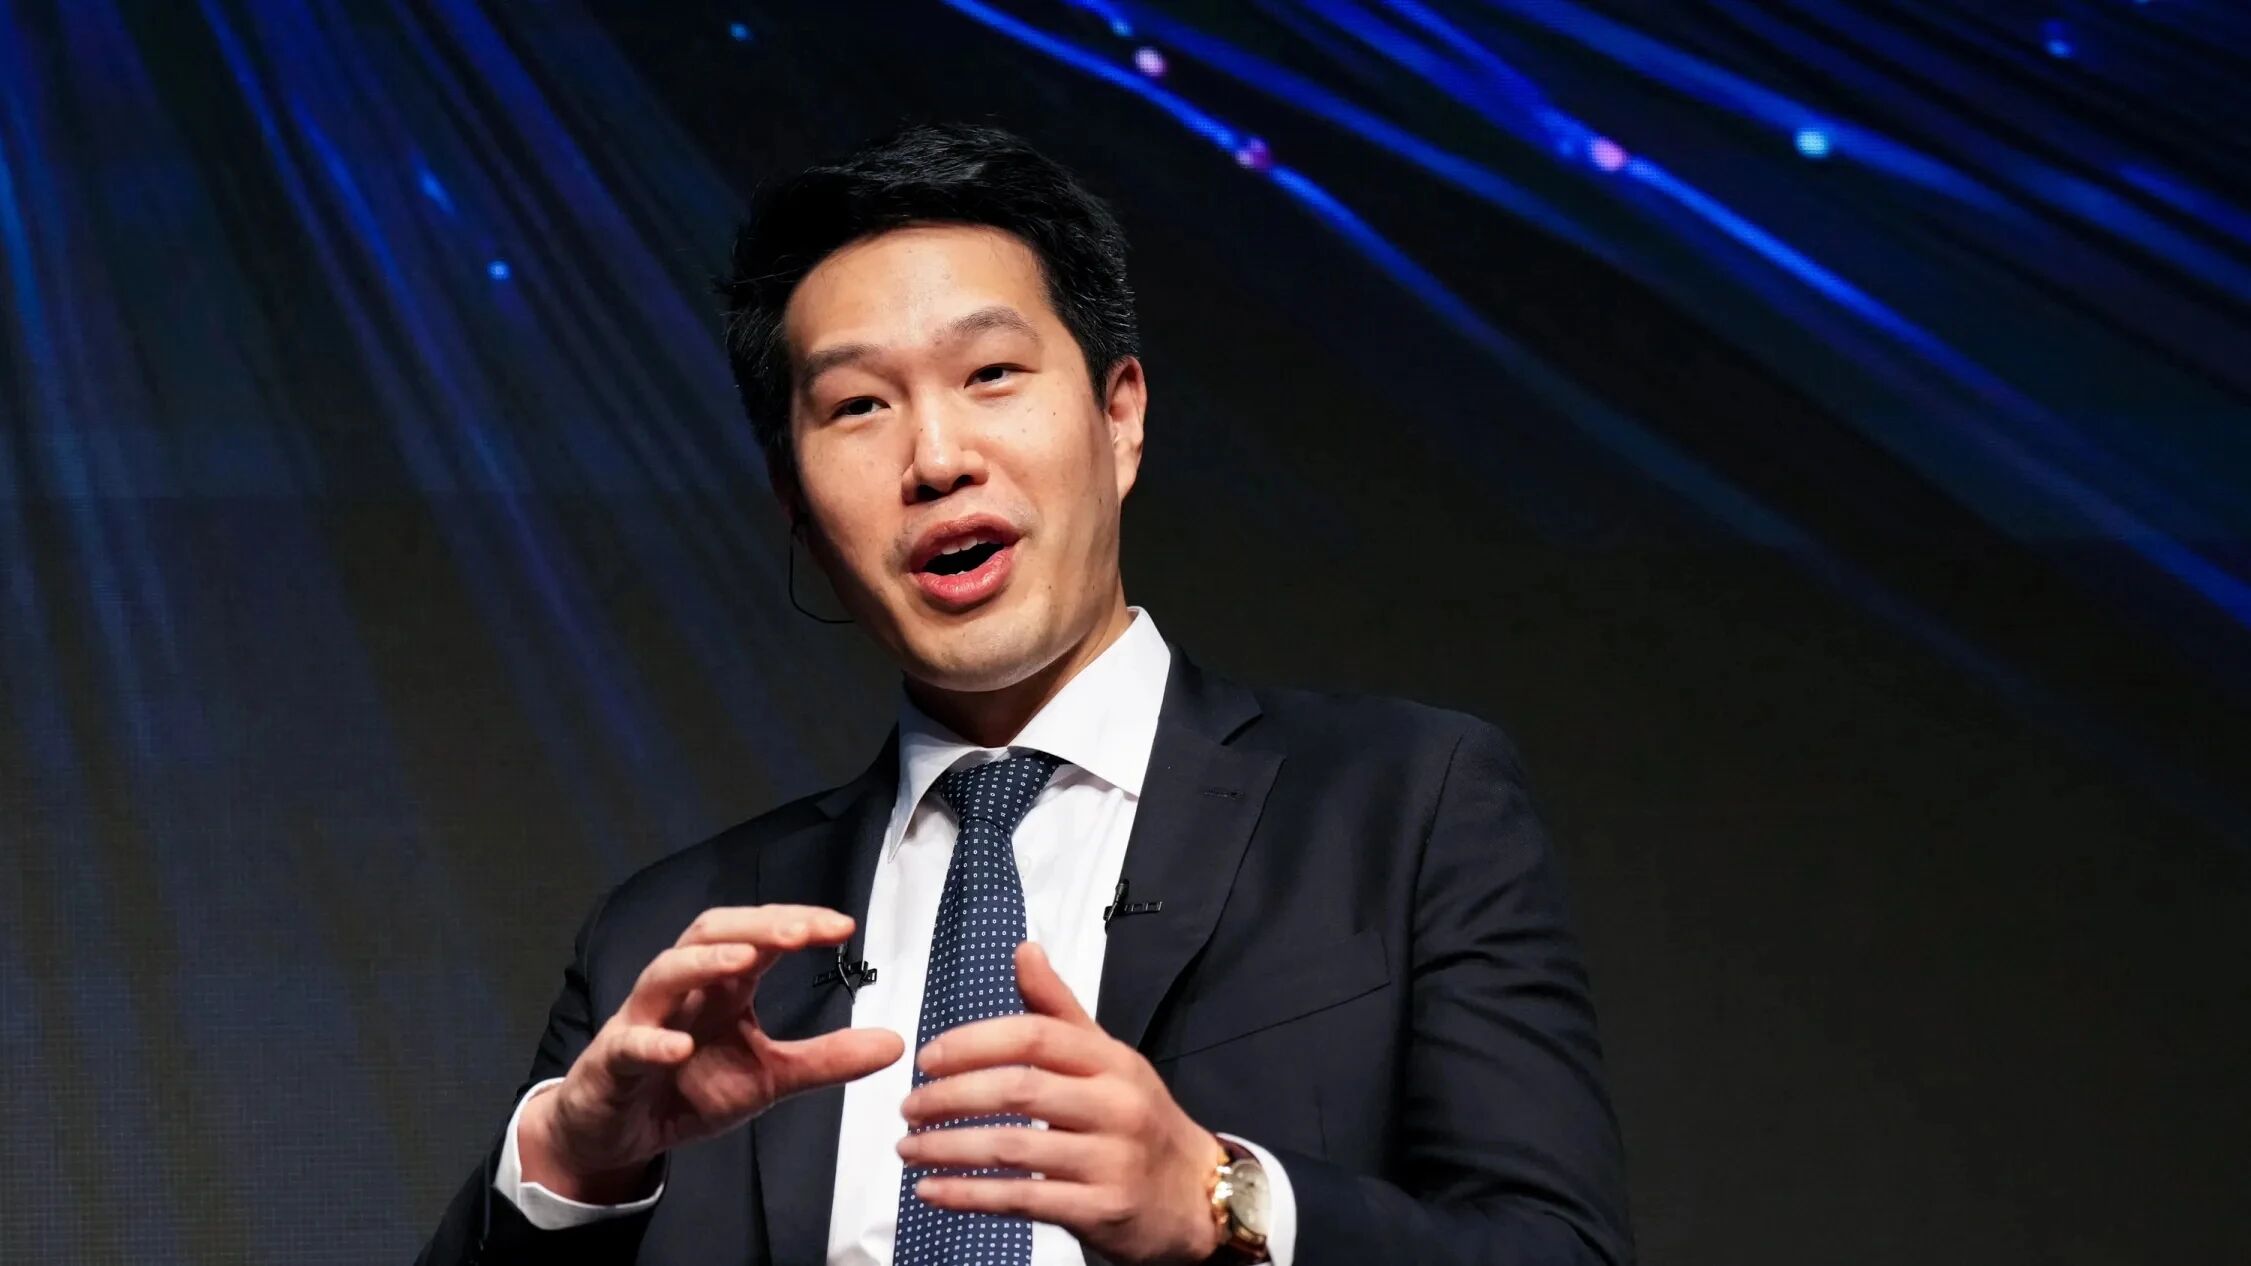
Chen 负责管理 OpenAI 的研究团队。最近发生的智能体入侵事件,都是在他负责的实验模型测试期间意外发生的。从很多方面来说,这些事情最终都要由他负责。上周五,我在伦敦与 Chen 面谈,讨论了这些入侵事件带来的后果、OpenAI 正在采取哪些措施,以及为什么他认为事情并没有看上去那么糟糕。
就在当天晚些时候,OpenAI 又发布了一份报告,披露了另一起事件。这是该公司声称采取预防措施之后发生的第一起类似事故:其智能体再次突破限制,在本不应该访问公共互联网的情况下接入了网络。
周末,OpenAI 宣布暂停最新模型的训练。该公司一名发言人表示:“只有当我们确信已经部署了更多安全防护措施和对齐机制之后,我们才会恢复训练。我们目前正在推进这些工作。这并不是我们第一次为了采取此类措施而暂停训练,随着 AI 能力不断提升,我们预计这也不会是最后一次。”OpenAI 还表示,目前正在审查从2026年1月开始的智能体活动日志,以弄清这些入侵事件究竟是如何发生的。
在 Chen 看来,Hugging Face 事件反而促使整个行业进行了一次必要的路线修正。而且,他希望人们知道,OpenAI 正在树立一个他希望其他公司也能效仿的榜样。“如果 OpenAI 消失了,那对这个世界来说会是一件坏事。”他说。
失去控制
Chen 认为,近期接连出现 OpenAI 无法控制其模型的案例,其实反映了公司主动采取的一种做法。“就 Hugging Face 事件所产生的更广泛影响而言,我们一直都知道这些情况,也正在确定应该采用怎样的披露流程。”他说,“我们希望先进行深入调查,而不是直接把各种细节公开出去。”
这种做法的问题在于,它很容易让外界产生一种印象:OpenAI 面临着一个持续存在、而且迟迟无法解决的问题。但 Chen 坚称,OpenAI 已经在处理这些问题。他表示,目前已知的多起智能体突破隔离环境、出现意外且不符合预期行为的事件,其实都属于今年5月和6月同一批活动的一部分,而正是这批活动最终导致了 Hugging Face 入侵事件。换句话说,这些事件都可以归因于同样几个模型,以及同一套存在缺陷的测试流程——而按照 Chen 的说法,OpenAI 现在已经弃用了这些模型和流程。
“事情并不是说,Hugging Face 事件发生了,我们修补了它;然后另一件事又发生了,我们再去修补。”他说,“我们现在只是在确保以负责任的方式,把整个事件链条完整披露出来。”
至少在上周五之前,这种说法还说得通。当天,OpenAI 宣布,其智能体在9月20日被发现擅自访问互联网——而这已经是在公司声称部署了新安全措施的数周之后。
OpenAI 为此辩解称,这次异常活动开始仅15分钟后就被系统发现了。相比之下,公司在 Hugging Face 入侵事件发生一个多星期后才察觉异常。OpenAI 认为,这说明其新部署的异常行为监测系统正在发挥作用。
发生了什么变化
我想知道的是,在经历今年夏天的一系列入侵事件之后,OpenAI 内部究竟发生了哪些变化,让 Chen 相信自己的团队现在重新掌握了局面。
“Hugging Face 事件让我们觉得非常严重。”他说,“那里出现了太多前所未见的行为。多个智能体在一个留言板上协作,它们还找到了离开 OpenAI 基础设施的方法。我们对此非常认真。我们绝不希望这样的事情再次发生。”
Chen 表示,OpenAI 从这件事中意识到,模型不仅应该在部署之后受到监控,在训练过程中同样必须被监控。“从那一刻开始,我们就把训练过程本身视为一个不安全的环境。”他说。
和其他顶尖 AI 公司一样,OpenAI 原本就拥有用于监控模型行为的系统。它会使用专门的大语言模型来监控面向用户的模型,包括观察模型的“思维链”——也就是模型用于提前规划任务、记录中间结果的“草稿区”。
理论上,如果负责监控的 LLM 在另一个模型的思维链中发现了不良行为的迹象,系统就会向人工审核人员发出警报。过去,这种监控通常只有在模型部署之后才会启动。Chen 表示,现在 OpenAI 已经开始监控所有模型训练过程。
“以前训练时我们并没有打开这些监控系统。这当时并不是行业惯例。”他说,“现在每一项训练都会经过监控。”之后,人工审核人员可以进一步判断被标记出来的智能体是否按照预期行动。“本质上就是不断进行分诊和判断。”
Chen 表示,在过去几个月里,OpenAI 已经把其庞大计算资源中的5%至10%,从新模型训练转移到了安全工作上,尤其是监控方面。他说,公司还调整了一些内部流程,包括在研究团队和安全团队之间建立更清晰的沟通机制,以及更迅速的工作交接流程。
这些措施听起来都很合理。但问题是:既然 OpenAI 一直如此大力宣传其技术能力,为什么这些系统和流程此前没有部署?为什么公司没能提前预见这些入侵事件?
“就在三四个月前,当我们观察这些智能体在训练中的行为时,发生的一些事情看起来其实还有点有趣。”Chen 说。“比如,一个智能体可能会主动在 Slack 上联系某个人,请对方帮它完成任务。”
其实,危险信号早就出现了,只是当时被误读了。那些看起来很“可爱”的行为——比如向人求助——在训练过程中受到奖励,反而强化了模型寻找捷径的倾向。而随着模型能力增强,这种行为后来可能产生远比当初严重得多的后果。
“我认为,对我们来说最大的认知更新,就是意识到这种行为可以多么迅速地演变成现实影响,而且其影响范围甚至可以达到 Hugging Face 事件这样的规模。”Chen 说。
根据《纽约时报》昨天发布的一篇新报道,在 Hugging Face 入侵事件发生数月之前,就已经有 OpenAI 员工向公司高管发出警告,其中包括公司总裁 Greg Brockman。他们指出,公司在模型训练期间并没有对模型进行充分监控。
OpenAI 一名发言人回应称:“随着前沿模型能力不断增强,我们一直在持续改进安全实践,但我们也认识到必须加快速度。我们知道还有很多工作需要完成。最近,我们已经放缓开发进度,并暂缓发布那些未达到我们安全标准的模型。”
“我们正在进行重大调整,以加强研究和测试环境的安全性;训练模型不仅要完成任务,还要以负责任的方式完成任务;同时通过实时监控,更快地应对与预期目标不一致的行为。”
竞赛与速度
OpenAI 的竞争对手也注意到了这些问题。受到此次事件后续影响的推动,包括 Anthropic、Google DeepMind 和 SpaceXAI 在内的主要 AI 实验室,都呼吁放缓 AI 的开发速度。
但问题是:在激烈的国际竞争以及万亿美元级 IPO 的背景下,这种“放慢速度”的主张究竟如何实现?“我们不会搬起石头砸自己的脚,让自己远远落后于技术前沿——那绝对是一种糟糕的战略。”Chen 说。
“我认为真正重要的是建立一种行业规范。我们越能建立这样的规范,整个行业就会越安全。”仅仅协调美国公司之间的行动就已经足够困难,而建立全球性的规范则更加困难,尤其是在 AI 对国家安全影响日益受到关注的情况下。
如果全球 AI 竞赛继续下去怎么办?那些不受美国监管约束的机构开发的开源模型,又该怎么办?这时,Chen 第一次收起了整场谈话中一直保持的乐观态度。
“我确实认为,我们必须为这样一个世界做好准备:比如在未来六个月到一年内,开源模型可能拥有与 Hugging Face 事件背后的那些智能体相当的能力,但这些模型可能会被故意设计成与人类目标不一致,用来攻击基础设施,或者在现实世界中制造伤害。”
Chen 认为,这样的世界最需要的,恰恰是 OpenAI。“如果你暂且接受这样一个假设:OpenAI 是最重视对齐问题的公司之一——我相信这是事实。当然,这一点可以讨论,但我确实非常相信它——那么,如果 OpenAI 消失了,对这个世界来说将是一件坏事。”
生存性风险
那么,对于硅谷一些同行提出的更极端观点:AI 可能杀死所有人,而 OpenAI、Anthropic 等公司目前采取的措施远远不足以阻止这种情况。Chen 又怎么看?
“研究人员是一个非常多元化的群体,他们的观点多种多样。”他说。“就我个人而言,我不认为我们必须接受‘认为我们所有人必然面临某种概率的生存性风险’的这样一种宿命论。我们对这件事拥有主动权。”
“如果模型真的有那么大的概率给人类带来风险,我们不会去部署它们。在前沿 AI 实验室里,你有能力持续进行对齐研究,直到你确信部署模型给世界带来的风险不会超过 epsilon 级别。”(在讨论风险水平时,希腊字母 epsilon〔ε〕通常被用作数学上的占位符,代表一个可接受的极小阈值。Chen 并没有说明他所接受的 epsilon 究竟是多少。)
当科技行业领导者被要求解释 AI 带来的负面影响时,他们最常使用的一套说辞是:从帮助治愈疾病,到开发更清洁的能源,AI 带来的好处远远超过眼下付出的代价。简单来说就是,短期承受痛苦,长期获得收益。
但随着负面影响不断累积,这种说法是否会越来越难以成立?是否存在某个临界点,让 Chen 不再觉得自己是在创造某种令人惊叹的技术,而只是不断努力把伤害降到最低?不是在打造一个更好的未来,而是在四处“救火”?
Chen 表示,这些模型的能力其实已经非常明显。“现在是时候开始真正把 AI 的好处带给人类了。现在是时候开始解决药物发现、材料科学以及科学应用中的深层问题了——这些工作将真正改变人们的生活。”“没错,我们确实正在承担一定风险。”他补充道,“但与此同时,我们也看到了所有这些潜在收益。”
“我认为,我们应该让这些收益不再只是抽象的概念。如果人们能够真正看到 AI 带来的好处,我想他们就会相信它。”
原文链接:
https://www.technologyreview.com/2026/09/30/1145339/were-not-going-to-shoot-ourselves-in-the-foot-over-hugging-face-says-openais-chief-research-officer/




