一. 简介
在 HTTP/1.1(请参阅[RFC7230])中,header 字段未被压缩。随着网页内的请求数增长到需要数十到数百个请求的时候,这些请求中的冗余 header 字段不必要地消耗了带宽,从而显着增加了延迟。
SPDY [SPDY] 最初通过使用 DEFLATE [DEFLATE] 格式压缩 header 字段来解决此冗余问题,事实证明,这种格式非常有效地表示了冗余 header 字段。但是,这种方法暴露了安全风险,如 CRIME(轻松实现压缩率信息泄漏)攻击所证明的安全风险(请参阅 [CRIME])。
本规范定义了 HPACK,这是一种新的压缩方法,它消除了多余的 header 字段,将漏洞限制到已知的安全攻击,并且在受限的环境中具有有限的内存需求。第 7 节介绍了 HPACK 的潜在安全问题。
HPACK 格式特意被设计成简单且不灵活的形式。两种特性都降低了由于实现错误而引起的互操作性或安全性问题的风险。没有定义扩展机制;只能通过定义完整的替换来更改格式。
1. 总览

本规范中定义的格式将 header 字段列表视为 name-value 对的有序集合,其中可以包括重复的对。名称和值被认为是八位字节的不透明序列,并且 header 字段的顺序在压缩和解压缩后保持不变。
header 字段表将 header 字段映射到索引值,从而得到编码。这些 header 字段表可以在编码或解码新 header 字段时进行增量更新。
在编码形式中,header 字段以字面形式表示或作为对 header 字段表中的一个 header 字段的引用。因此,可以使用引用和字面值的混合来编码 header 字段的列表。
字面值可以直接编码,也可以使用静态霍夫曼编码(最高压缩比 8:5)。
编码器负责决定将哪些 header 字段作为新条目插入 header 字段表中。解码器执行对编码器指定的 header 字段表的修改,从而在此过程中重建 header 字段的列表。这使解码器保持简单并可以与多种编码器互操作。
附录C 中提供了使用这些不同的机制表示 header 字段的示例。
注:在 HTTP/2 中,请求和响应标头字段的定义保持不变,仅有一些微小的差异:所有标头字段名称均为小写,请求行现在拆分成各个 :method、:scheme、:authority 和 :path 伪标头字段。
2. 约定
本文档中的关键字 “必须”,“不得”,“必须”,“应”,“应禁止”,“应”,“不应”,“建议”,“可以”和“可选”是 RFC 2119 [RFC2119] 中定义的。
所有数值均以网络字节顺序排列。 除非另有说明,否则值是无符号的。适当时以十进制或十六进制提供字面值。
3. 术语
本文使用以下术语:
Header Field:一个名称/值 name-value 对。名称和值都被视为八位字节的不透明序列。
Dynamic Table:动态表(请参阅第 2.3.2 节)是将存储的 header 字段与索引值相关联的表。该表是动态的,并且特定于编码或解码上下文。
Static Table:静态表(请参阅第 2.3.1 节)是将经常出现的 header 字段与索引值静态关联的表。该表是有序的,只读的,始终可访问的,并且可以在所有编码或解码上下文之间共享。
Header List:header 列表是 header 字段的有序集合,这些 header 字段经过联合编码,可以包含重复的 header 字段。HTTP/2 header 块中包含的 header 字段的完整列表是 header 列表。
Header Field Representation:header 字段可以编码形式表示为字面或索引(请参见第 2.4 节)。
Header Block:header 字段表示形式的有序列表,解码后会产生完整的 header 列表。
二. 压缩过程概述
本规范未描述编码器的具体算法。相反,它精确定义了解码器的预期工作方式,从而允许编码器产生此定义允许的任何编码。
1. Header List Ordering
HPACK 保留 header 列表内 header 字段的顺序。编码器必须根据其在原始 header 列表中的顺序对 header 块中的 header 字段表示进行排序。解码器必须根据其在 header 块中的顺序对已解码 header 列表中的 header 字段进行排序。
2. Encoding and Decoding Contexts
为了解压缩 header 块,解码器只需要维护一个动态表(参见第 2.3.2 节)作为解码上下文。不需要其他动态状态。
当用于双向通信时(例如在 HTT P中),由端点维护的编码和解码动态表是完全独立的,即请求和响应动态表是分开的。
3. Indexing Tables
HPACK 使用两个表将 header 字段与索引相关联。静态表(请参阅第 2.3.1 节)是预定义的,并包含公共 header 字段(其中大多数带有空值)。动态表(请参阅第 2.3.2 节)是动态的,编码器可以使用它来索引已编码 header 列表中重复的 header 字段。
这两个表被合并到一个用于定义索引值的地址空间中(请参阅第 2.3.3 节)。
(1) 静态表
静态表由 header 字段的预定义静态列表组成。其条目在附录 A 中定义。
(2) 动态表
动态表包含以先进先出的顺序维护的 header 字段列表。动态表中的第一个条目和最新条目在最低索引处,而动态表的最旧条目在最高索引处。
动态表最初是空的。当每个 header 块被解压缩时,将添加条目。动态表可以包含重复的条目(即,具有相同名称和相同值的条目)。因此,解码器不得将重复的条目视为错误。
编码器决定如何更新动态表,因此可以控制动态表使用多少内存。为了限制解码器的存储需求,动态表的 size 受到严格限制(请参见第 4.2 节)。
解码器在处理 header 字段表示列表时更新动态表(请参见第 3.2 节)。
(3) 索引地址空间
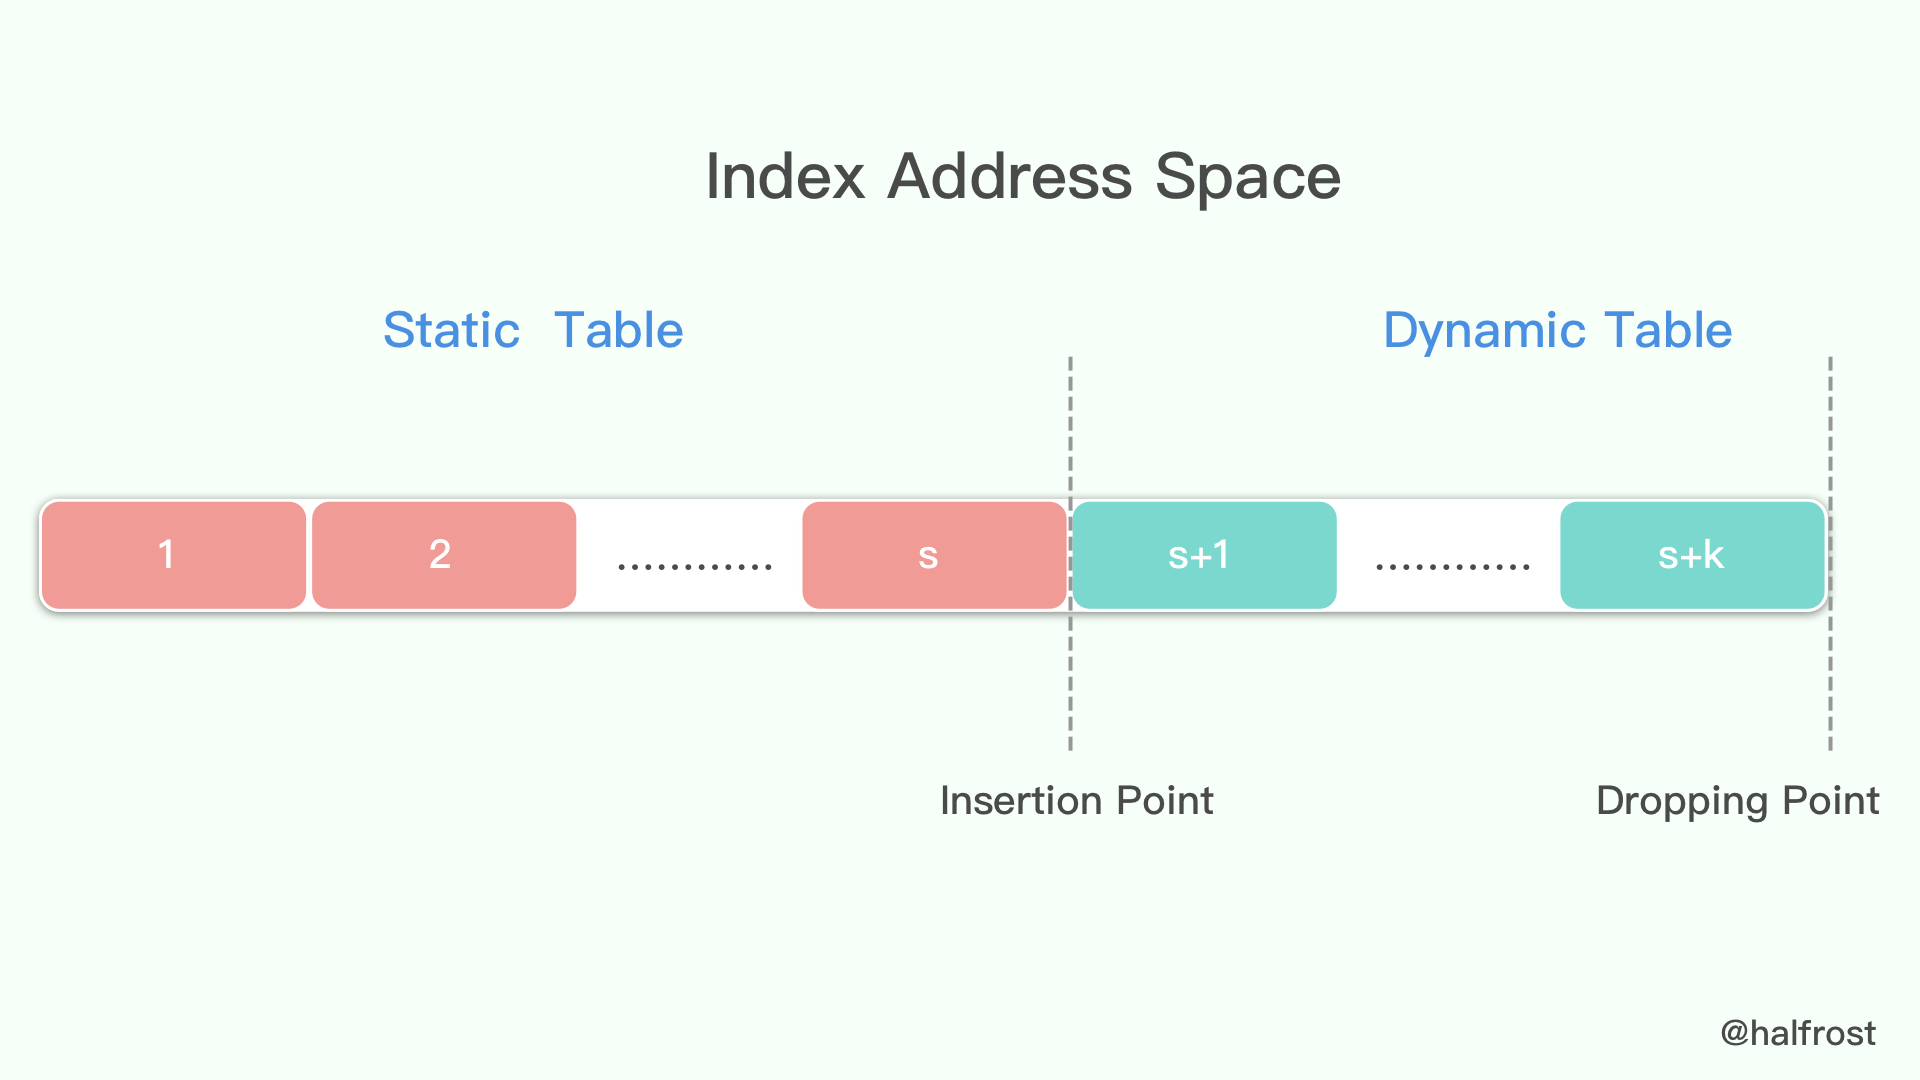
静态表和动态表被组合到单个索引地址空间中。
在 1 和静态表的长度(包括在内)之间的索引是指静态表中的元素(请参阅第 2.3.1 节)。
严格大于静态表长度的索引是指动态表中的元素(请参见第 2.3.2 节)。 减去静态表的长度即可找到动态表的索引。
严格大于两个表的长度之和的索引必须视为解码错误。
对于 s 的静态表 size 和 k 的动态表 size ,下图显示了整个有效索引地址空间
4. Header Field Representation
编码的 header 字段可以表示为索引或字面。
有索引的表示形式定义了一个 header 字段,作为对静态表或动态表中条目的引用(请参见第 6.1 节);字面表示形式通过指定其 name 和 value 来定义 header 字段。header 字段 name 可以用字面形式表示,也可以作为对静态表或动态表中条目的引用。header 字段 value 按字面表示。定义了三种不同的字面表示形式:
-
在动态表的开头添加 header 字段作为新条目的字面表示形式(请参见第 6.2.1 节)。
-
不将 header 字段添加到动态表的字面表示形式(请参见第 6.2.2 节)。
-
不将 header 字段添加到动态表的字面表示形式,另外规定该 header 字段始终使用字面表示形式,尤其是在由中介程序重新编码时(请参阅第 6.2.3 节)。此表示旨在保护 header 字段值,这些 header 字段值通过压缩以后就不会受到威胁(有关更多详细信息,请参见第 7.1.3 节)。
为了保护敏感的 header 字段值(请参阅第 7.1 节),可以从安全考虑出发选择这些字面表示形式之一。
header 字段 name 或 header 字段 value 的字面表示可以直接或使用静态霍夫曼代码对八位字节序列进行编码(请参见第 5.2 节)
三. header 块的解码
1. Header Block Processing
解码器顺序处理 header 块以重建原始 header 列表。
header 块是 header 字段表示形式的串联。第 6 节中介绍了不同的可能的 header 字段表示形式。
一旦 header 字段被解码并添加到重建的 header 列表中,就不能删除 header 字段。添加到 header 列表的 header 字段可以安全地传递到应用程序。
通过将结果 header 字段传递给应用程序,除了动态表所需的内存外,还需要使用最少的临时内存来实现解码器。
2. Header Field Representation Processing
在本节中定义了对 header 块进行处理以获得 header 列表的过程。为了确保解码将成功产生 header 列表,解码器必须遵守以下规则。
header 块中包含的所有 header 字段表示形式将按照它们出现的顺序进行处理,如下所示。有关各种 header 字段表示形式的格式的详细信息以及一些其他处理指令,请参见第 6 节。
_indexed representation_需要执行以下操作:
- 与静态表或动态表中被引用条目相对应的 header 字段被附加到解码后的 header 列表中。
动态表中未添加的 “_literal representation_” 需要执行以下操作:
- header 字段被附加到解码的 header 列表中。
在动态表中添加了 “_literal representation_” 需要执行以下操作:
- header 字段被附加到解码的 header 列表中。
- header 字段插入在动态表的开头。这种插入可能导致驱逐动态表中的先前条目(请参见第 4.4 节)。
四. 动态表管理

为了限制解码器端的存储要求,动态表的 size 受到限制。
动态字典上下文有关,需要为每个 HTTP/2 连接维护不同的字典。
1. Calculating Table Size
动态表的 size 是其表项 size 的总和。条目的 size 是其 name 的长度(以八位字节为单位)(如第 5.2 节中所定义),value 的长度(以八位字节为单位)和 32 的总和。条目的 size 是使用其 name 和 value 的长度来计算的,而无需应用任何霍夫曼编码。
注意:额外的 32 个八位字节说明了与条目相关的估计开销。例如,使用两个 64 位指针引用条目的 name 和 value 以及使用两个 64 位整数来计数对该 name 和 value 的引用次数的条目结构,该数据结构将具有 32 个八位字节的开销。(64*2*2/8=32 字节)
2. Maximum Table Size
使用 HPACK 的协议确定允许编码器用于动态表的最大 size 。在 HTTP/2 中,此值由 SETTINGS_HEADER_TABLE_SIZE 设置来确定(请参见[HTTP2]的 6.5.2 节)。
编码器可以选择使用小于此最大 size 的容量(请参阅第 6.3 节),但是所选 size 必须保持小于或等于协议设置的最大容量。
动态表最大 size 的变化是因为动态表 size 的更新引起的(请参见第 6.3 节)。动态表 size 更新必须在更改动态表 size 之后的第一个 header 块的开头进行。在 HTTP/2 中,这遵循 settings 的确认(请参阅 [HTTP2]的 6.5.3 节)。
在传输两个 header 块之间,可能会发生多次最大表 size 的更新。如果在此间隔中,这个 size 更改一次以上的话,那么就必须在动态表 size 更新中,用信号通知在该间隔中出现的,最小的最大表 size 。一定会发出最终最大 size 的信号,从而导致最多两个动态表 size 的更新。这样可确保解码器能够基于动态表 size 的减小执行逐出(请参见第 4.3 节)。
使用此机制通过将最大 size 设置为 0,从动态表中完全清除条目,然后可以将其恢复。
HTTP/2 提倡使用尽可能少的连接数,头部压缩是其中一个重要的原因:在同一个连接上产生的请求和响应越多,动态字典累积的越全,头部压缩的效果就越好。
3. Entry Eviction When Dynamic Table Size Changes
只要减小了动态表的最大 size,就会从动态表的末尾逐出条目,直到动态表的 size 小于或等于最大 size 为止。
4. Entry Eviction When Adding New Entries
在将新条目添加到动态表之前,将从动态表的末尾逐出条目,直到动态表的 size 小于或等于(最大 size -新条目大小)或直到表为空。
如果新条目的 size 小于或等于最大 size,则会将该条目添加到表中。 尝试添加大于最大 size 的条目不是错误;尝试添加大于最大 size 的条目会导致该表清空所有现有条目,并导致表为空。
新条目可以引用动态表中条目 A 的 name,当将该新条目添加到动态表中时,该条目 A 将被逐出。请注意,如果在插入新条目之前从动态表中删除了引用条目,则应避免删除引用 name。
五. 基本类型表示
HPACK 编码使用两种原始类型:无符号的可变长度整数和八位字节串。
1. Integer Representation
整数用于表示 name 索引,header 字段索引或字符串长度。整数表示可以在八位字节内的任何位置开始。为了优化处理,整数表示总是在八位字节的末尾结束。
整数分为两部分:填充当前八位字节的前缀和可选的八位字节列表,如果整数值不适合该前缀,则使用这些可选的八位字节。前缀的位数(称为 N)是整数表示的参数。
如果整数值足够小,即严格小于 2^N-1,则将其编码在 N 位前缀中。
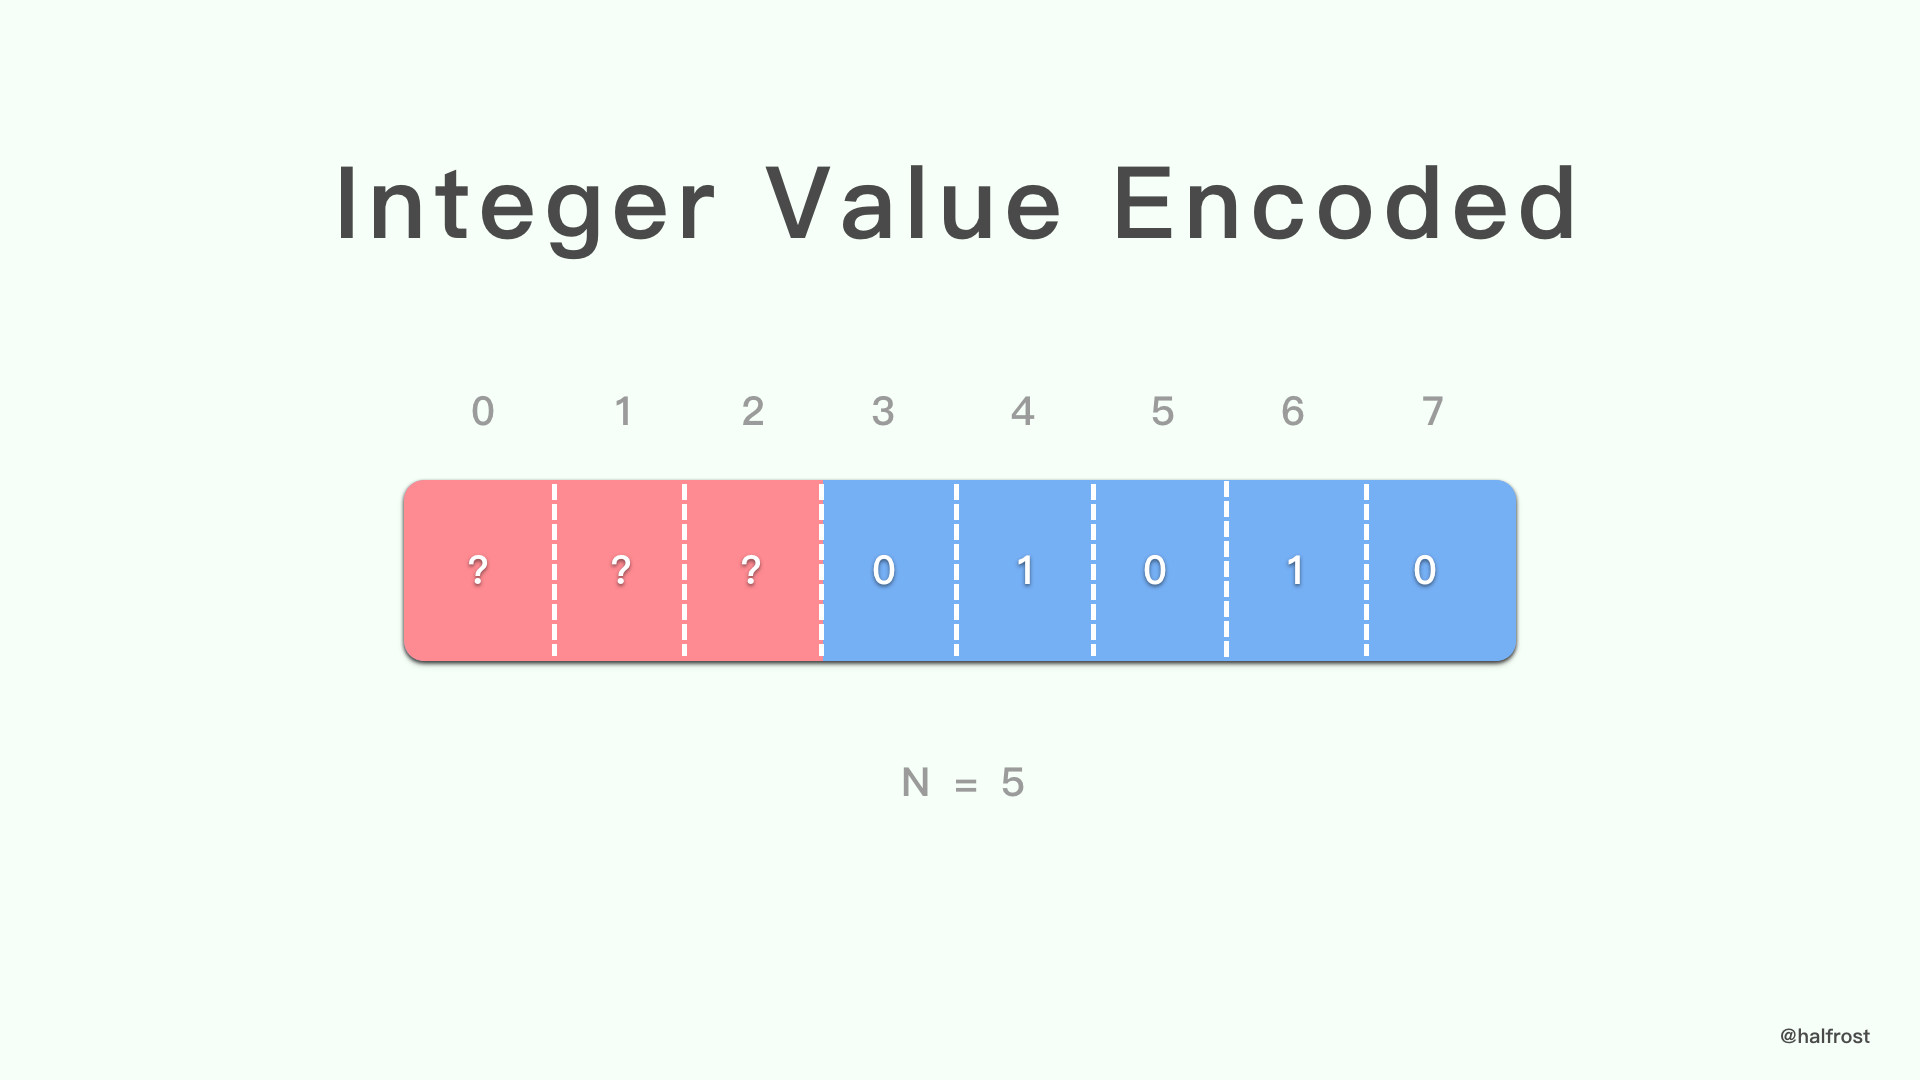
上图的例子中,N = 5,所以能表示的最大的整数是 2^5-1 = 31
如果整数数值大于 2^N-1,则将前缀的所有位设置为 1,并使用一个或多个八位字节的列表对减少了 2^N-1 的值进行编码。每个八位字节的最高有效位用作连续标志:除了列表中的最后一个八位字节,其值均设置为 1。八位字节的其余位用于对减小的值进行编码。
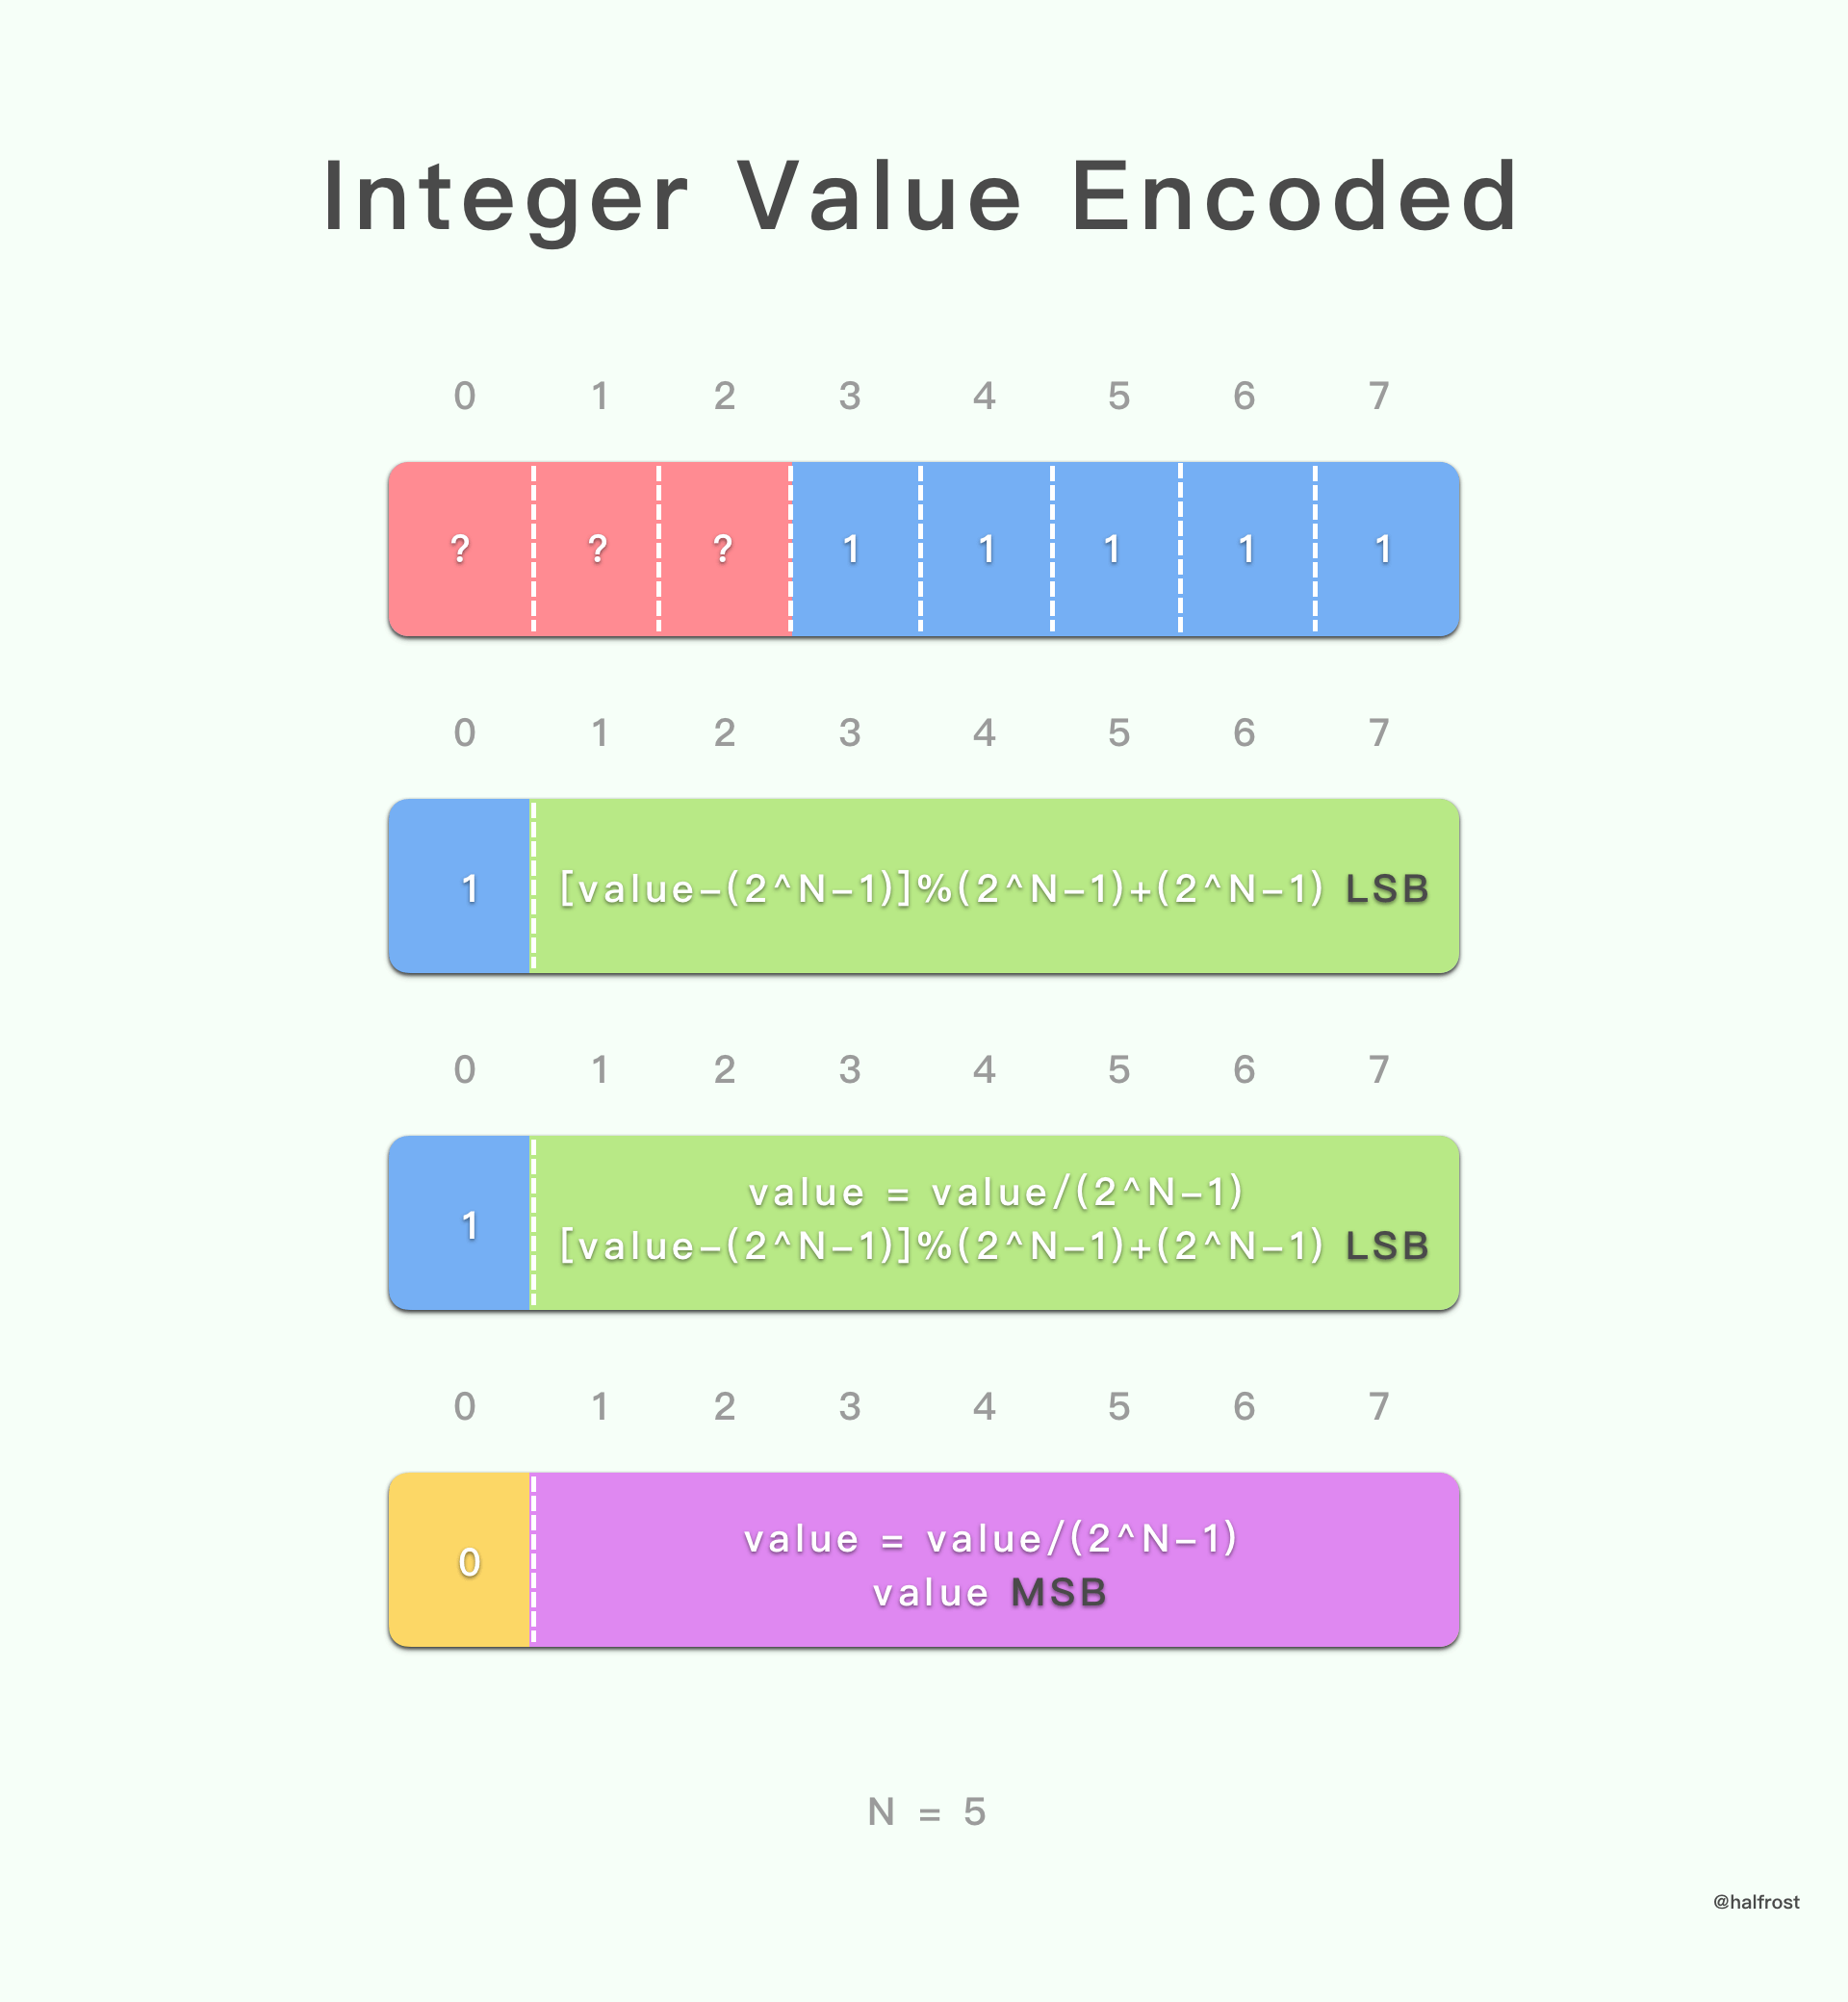
从八位字节列表中解码整数值是通过反转八位字节在列表中的顺序开始的。 然后,对于每个八位字节,将其最高有效位删除。八位字节的其余位被级联起来,结果值增加 2^N-1 以获得整数值。
前缀 size N 始终在 1 到 8 位之间。从八位字节边界开始的整数将具有 8 位前缀。
表示整数 I 的伪代码如下:
if I < 2^N - 1, encode I on N bits else encode (2^N - 1) on N bits I = I - (2^N - 1) while I >= 128 encode (I % 128 + 128) on 8 bits I = I / 128 encode I on 8 bits 用于解码整数 I 的伪代码如下:
decode I from the next N bits if I < 2^N - 1, return I else M = 0 repeat B = next octet I = I + (B & 127) * 2^M M = M + 7 while B & 128 == 128 return I 附录 C.1 中提供了说明整数编码的示例。
整数表示形式允许使用不确定大小的值。编码器也可能发送大量的零值,这可能浪费八位字节,并可能使整数值溢出。超出实现限制的整数编码(值或八位字节长度)必须视为解码错误。基于实现方的约束,可以为整数的每种不同用途设置不同的限制。
2. String Literal Representation
header 字段 name 和 header 字段 value 可以表示为字符串字面量。可以通过直接编码字符串字面的八位字节或使用霍夫曼代码将字符串字面编码为八位字节序列(请参见[HUFFMAN])
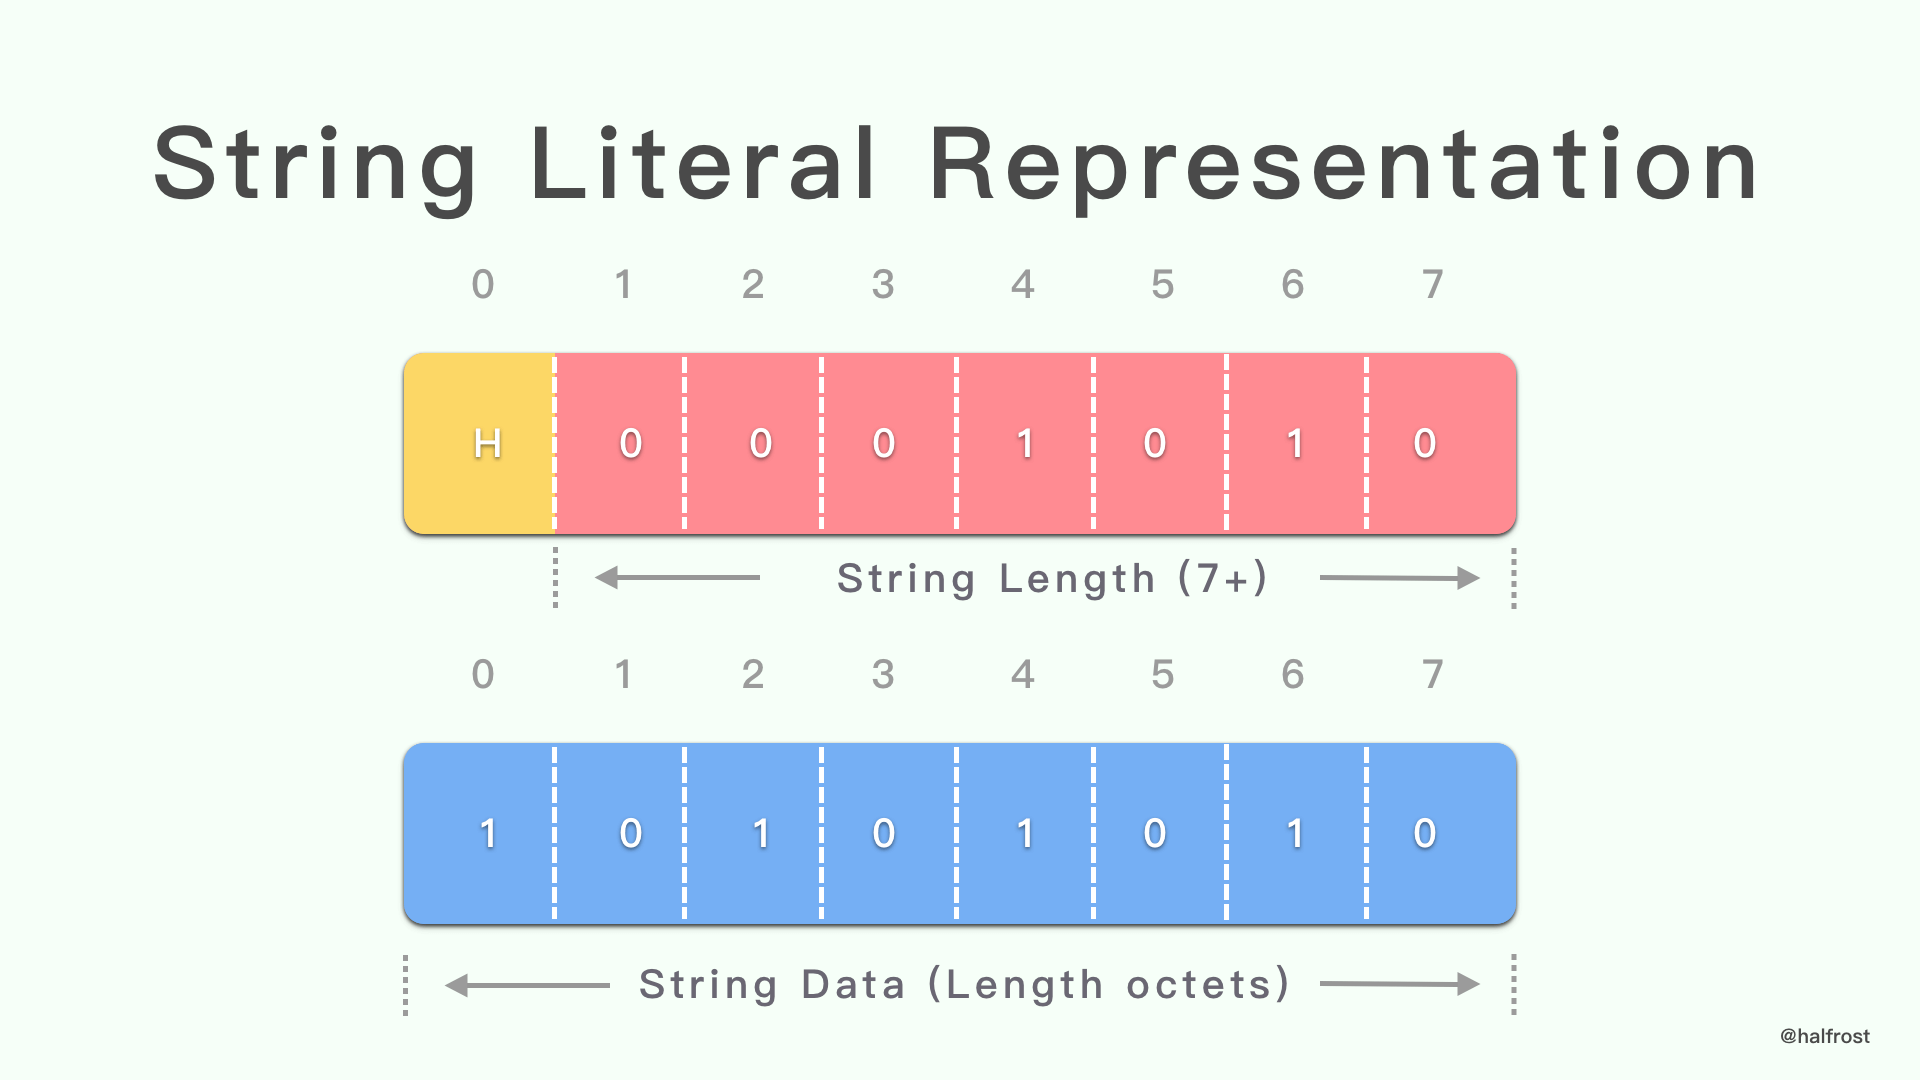
字符串字面表示形式包含以下字段:
-
H:
一位标志 H,指示字符串的八位字节是否经过霍夫曼编码。 -
String Length:
用于编码字符串字面的八位字节数,编码为带有 7 位前缀的整数(请参阅第 5.1 节)。 -
String Data:
字符串字面的编码数据。如果 H 为'0',则编码后的数据为字符串字面量的原始八位字节。如果 H 为'1',则编码数据为字符串字面量的霍夫曼编码。
使用霍夫曼编码的字符串字面量使用 附录 B 中定义的霍夫曼代码进行编码(有关示例,请参见 附录 C.4 中的示例以及 附录 C.6 中的响应示例)。编码的数据是与字符串字面的每个八位字节相对应的代码的按位级联。
由于霍夫曼编码的数据并不总是在八位字节的边界处结束,因此在其后插入填充,直到下一个八位字节的边界。为避免将此填充误解为字符串字面的一部分,使用了与 EOS(end-of-string)符号相对应的代码的最高有效位。
在解码时,编码数据末尾的不完整代码将被视为填充和丢弃。严格长于 7 位的填充必须被视为解码错误。与 EOS 符号的代码的最高有效位不对应的填充必须被视为解码错误。包含 EOS 符号的霍夫曼编码的字符串字面必须被视为解码错误。
六. 二进制格式
本节描述每种不同的 header 字段表示形式的详细格式以及动态表大小更新指令。
1. 索引 header 字段表示
索引 header 字段表示可标识静态表或动态表中的条目(请参见第 2.3 节)。
索引的 header 字段表示会将 header 字段添加到已解码的 header 列表中,如第 3.2 节所述。
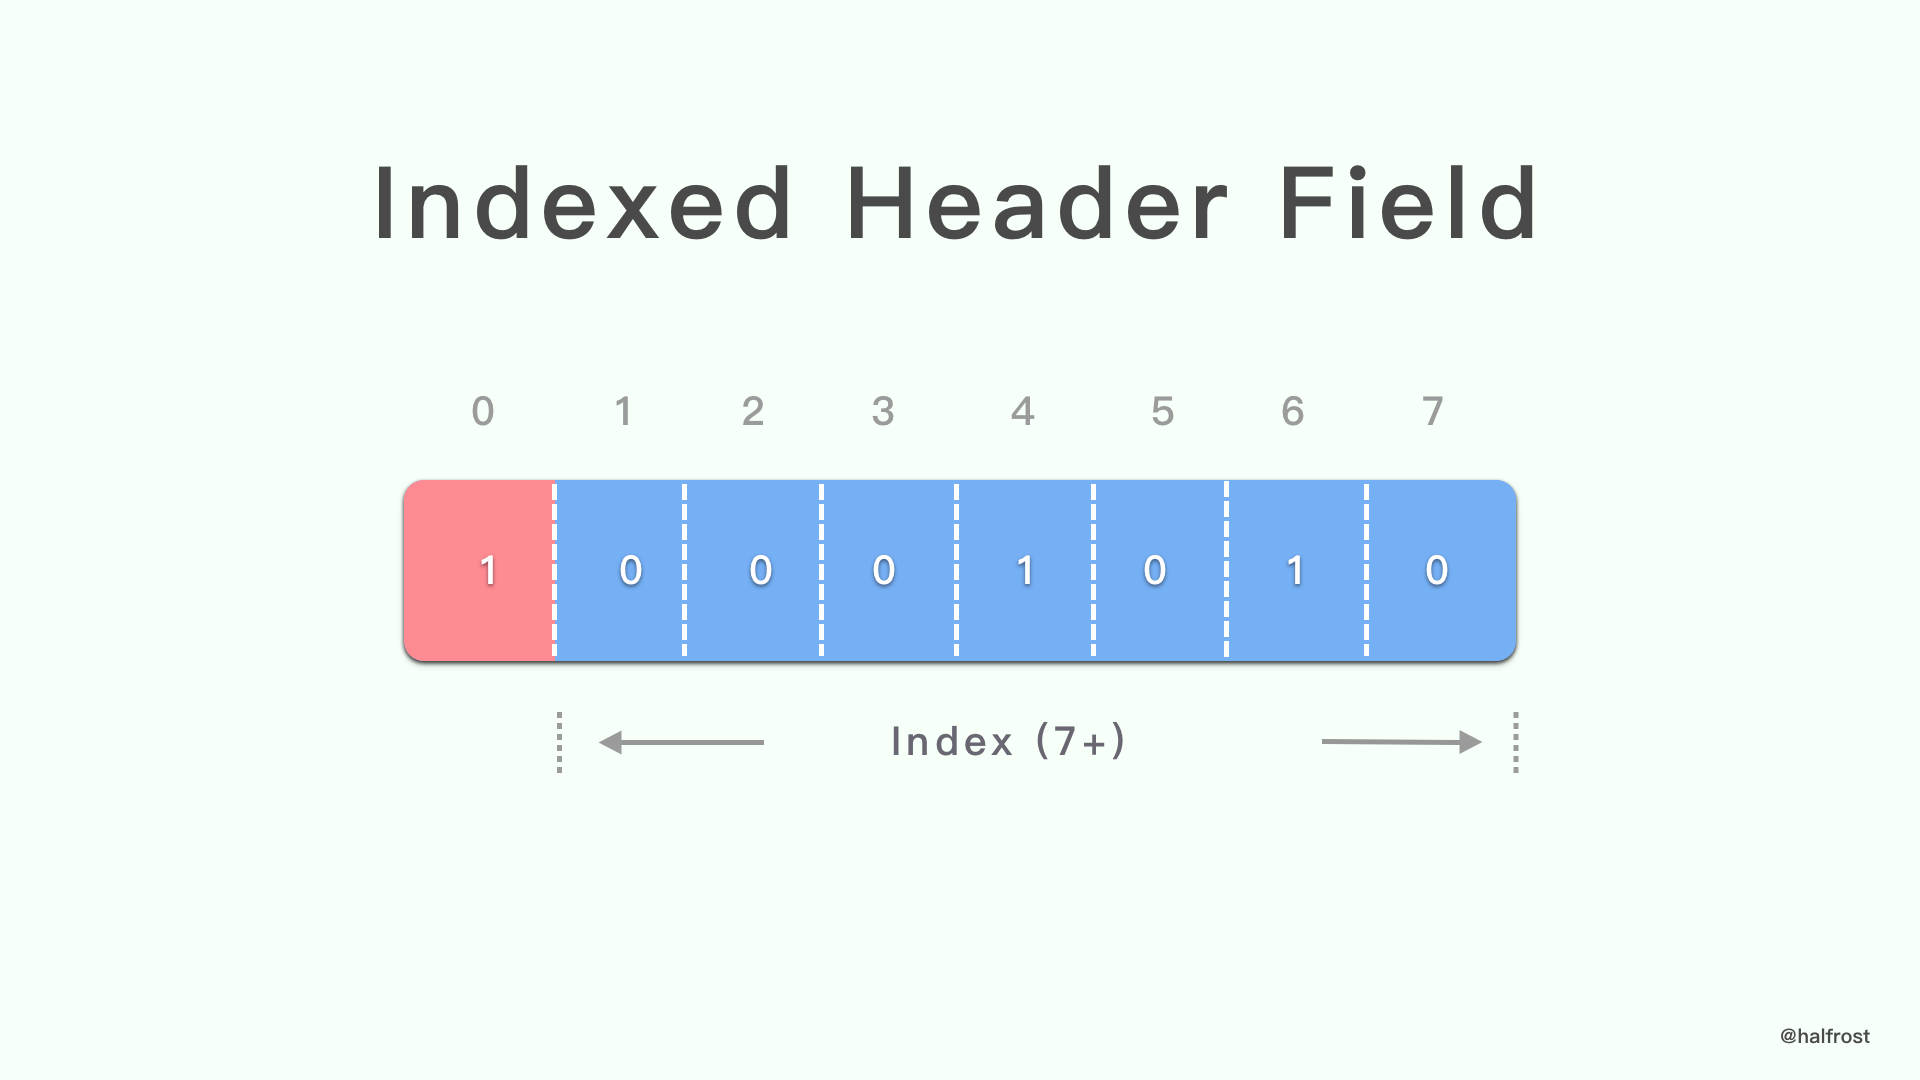
上面这种情况对应的是 Name 和 Value 都在索引表(包括静态表和动态表)中。
索引 header 字段以 1 位模式 “1” 开头,后跟匹配 header 字段的索引,以 7 位前缀的整数表示(请参 ...