无论是在聊 L2、隐私还是下一代 Web 技术,零知识证明都是经常会碰到的技术术语,听起来就像是科幻小说里的东西:向你证明我知道一个秘密,但绝不透露这个秘密本身,这简直是程序员的终极浪漫。
大多数人粗看都会觉得这东西是密码学博士们的专属玩具,我花了一段时间学习后,发现这条通往魔法世界的路似乎有迹可循,希望这篇入门介绍能帮助到更多这方向的学习者。
魔法洞穴
忘掉所有数学,我们先从一个故事开始——“阿里巴巴洞穴”,这是理解 ZKP 最经典的例子,最早由 Jean-Jacques Quisquater 等人于 1990 年在他们的论文《如何向你的孩子解释零知识协议》中发表。
想象一个环形洞穴,A、B 两个入口在前方,深处有一扇只有知道咒语才能打开的魔法门。Alice 知道咒语,现在,Alice 想向 Bob 证明她知道咒语,但又不想让 Bob 听到咒语是什么。
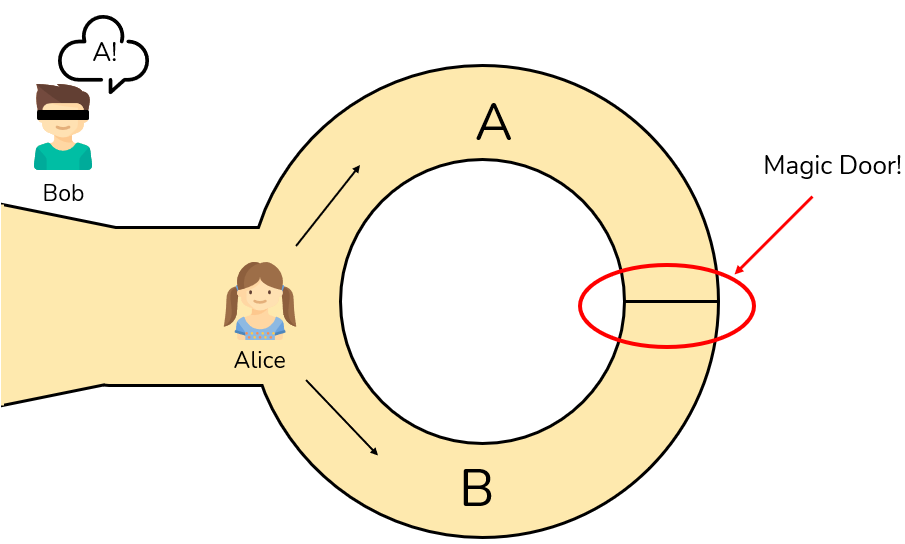
他们可以这样玩一个游戏:
-
承诺 (Commitment):Alice,作为证明者 (Prover),独自进入洞穴。然后可以随机从 A 口进,也可以从 B 口进。Bob 在洞外等着,但不知道 Alice 走了哪条路。
-
挑战 (Challenge):Bob 作为验证者 (Verifier),走到洞口然后随机喊出一个要求,比如:“从 B 通道出来!”
-
响应 (Response):Alice 听到要求后:
- 如果她当初就是从 B 进去的,那简单,就直接从 B 走出来。
- 如果她当初是从 A 进去的,就必须念动咒语打开那扇魔法门穿过去,然后从 B 通道出来。
-
验证 (Verification):Bob 看到 Alice 确实从 B 通道出来了,他对 Alice 的信任度增加了一点。
为什么说“一点”呢?因为如果 Alice 不知道咒语,她仍然有 50% 的概率蒙对(比如 Alice 从 B 进去,Bob 恰好也喊了 B)。
但如果这个游戏重复 20 次,Alice 每次都能从 Bob 指定的出口出来,那 Alice 每次都蒙对的概率就只有$$\left(\frac{1}{2}\right)^{20}$$,也就是大约是百万分之一。这时候 Bob 就有十足的把握相信,Alice 确实知道那个咒语。
这个小游戏完美地展示了 ZKP 的三大特性:
- 完整性 (Completeness):如果 Alice 真的知道咒语,她总能完成挑战。
- 可靠性 (Soundness):如果 Alice 不知道咒语,她几乎不可能骗过 Bob。
- 零知识性 (Zero-Knowledge):在整个过程中,Bob 除了“Alice 知道咒语”这个事实外,没有学到任何关于咒语本身的信息。
另外我们可以看到一个重要的属性是,零知识证明并非数学意义上的证明,因为可能存在一个很小很小的概率,即可靠性误差 – 作弊的证明者能够骗过验证者,但实际实践中我们几乎可以忽略这个极小的概率。
Where’s Wally
还有另外一个比较简单的例子来说明零知识证明: 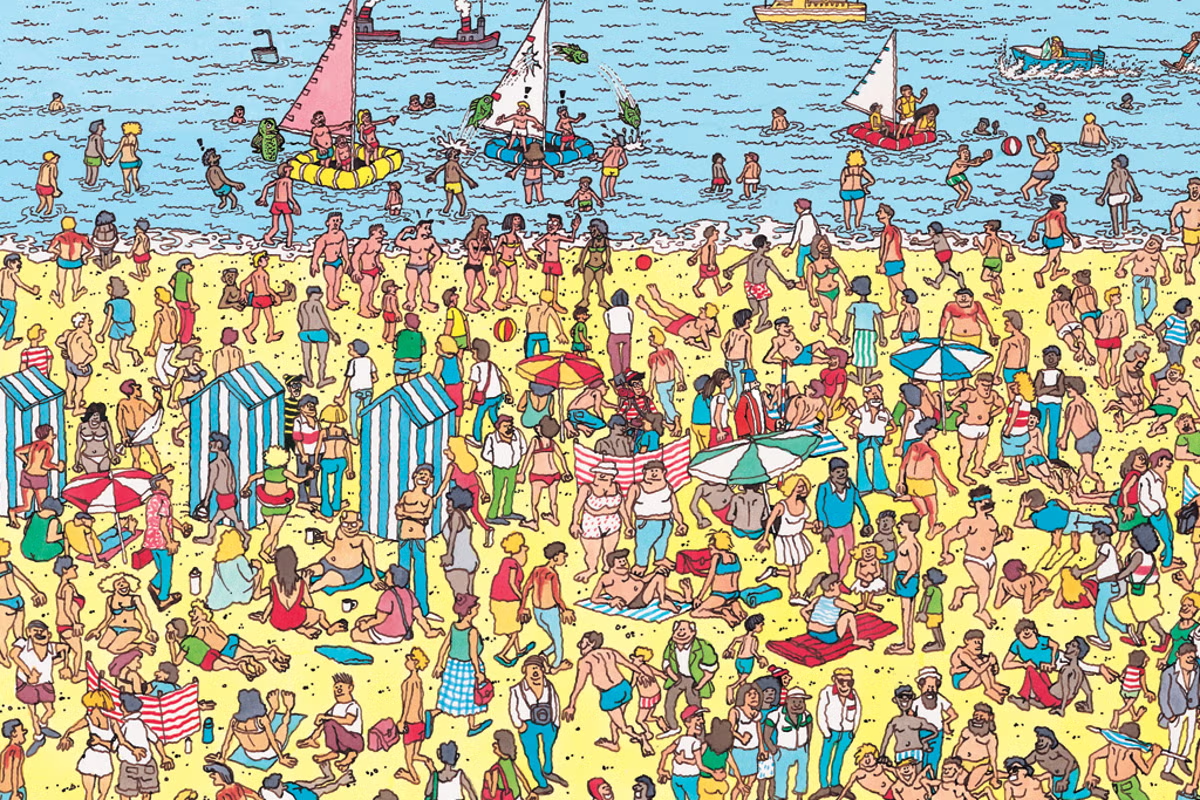
Alice 和 Bob 玩游戏看谁先找到 Wally,Alice 说她找到了,她想要证明自己已经得到了结果,但又不想透露更多信息给 Bob,所以她可以用一个几倍面积黑色的纸片遮住整个图画,然后把 Wally 位置那里在黑色纸片上打个小孔,这样 Bob 就可以看到 Wally,而不知道 Wally 在哪儿。注意这里为什么强调几倍面积的黑色纸片,如果是和原图相同大小的纸片,就可能暴露了 Wally 的大致方向和范围。
这个例子展示的 ZKP 另外一个特性是 Prover 通常是更耗费资源的 (从图片中找到 Wally 需要花费一定的时间),而 Verifier 通常能很快验证。这个特性才能让一些区块链项目利用 ZKP 把链上计算挪到链下计算,而链上只是做验证。
最简单的 ZKP 代码
两个例子很棒,但代码怎么写?
我接触到的第一个协议叫 Schnorr 身份验证,它要证明的是:“我知道与公钥 h 对应的私钥 x,其中 h = g^x mod p”。这里的“咒语”就是 x,而那扇“魔法门”就是离散对数问题——从 g, h, p 反推出 x 极其困难。
这个协议的“交互式”版本,完美地复刻了洞穴里的“一来一回”:
- Prover (我): 随机选个数
k,计算t = g^k mod p发给 Verifier。这叫“承诺”。 - Verifier (你): 随机给 Prover 一个数
c,这叫“挑战”。 - Prover: 根据收到的
c,计算r = k - c*x mod (p-1)并发回。这叫“响应”。 - Verifier: 验证
g^r * h^c mod p是不是等于 Prover 一开始给的t。
完整代码在iteractive_schnorr
fn iteractive_schnorr() { // 公开参数:素数 p=204859, g=5, x=6 (秘密), h = 5^6 mod 204859 = 15625 let p: BigInt = BigInt::from(204859u64); let g: BigInt = BigInt::from(5u32); let x: BigInt = BigInt::from(6u32); // 证明者的秘密 let h = g.modpow(&x, &p); // h = g^x mod p // 进行多轮证明 p for _ in 0..20 { // 证明者:生成承诺 t = g^k mod p let mut rng = thread_rng(); let k = rng.gen_bigint_range(&BigInt::one(), &(&p - BigInt::one())); let t = g.modpow(&k, &p); println!("证明者发送 t: {}", t); // 验证者:生成挑战 c (简化到 0..10) let c: BigInt = BigInt::from(rng.gen_range(0..10)); println!("验证者挑战 c: {}", c); // 证明者:响应 r = k - c * x mod (p-1) let order = &p - BigInt::one(); // 阶 let r = (&k - &c * &x).modpow(&BigInt::one(), &order); // 确保正数 println!("证明者响应 r: {}", r); // 验证者:检查 g^r * h^c == t mod p let left = g.modpow(&r, &p) * h.modpow(&c, &p) % &p; if left == t { println!("验证通过!"); } else { println!("验证失败!"); } } } 但一来一回也太麻烦了,互联网应用需要的是一次性的“证明”。经过一番研究,密码学家们想出的一个绝妙技巧,叫做 Fiat-Shamir 启发式证明。
它的核心思想是:用哈希函数来模拟一个不可预测的“挑战者”。
Prover 不再等待 Verifier 给出挑战 c,而是自己计算 c = hash(公开信息, 自己的承诺 t)。因为哈希函数的雪崩效应,Prover 无法预测 c 的值来作弊,这就巧妙地把交互过程压缩了。
我们可以用 Rust 写出这样一个完整的非交互式证明程序 fiat_shamir:
fn fiat_shamir() { // --- 公开参数 --- // 在真实世界,p 应该是至少 2048 位的安全素数 let p: BigInt = BigInt::from(204859u64); let g: BigInt = BigInt::from(2u64); // Prover 的秘密 (只有 Prover 知道) let secret_x: BigInt = BigInt::from(123456u64); // Prover 的公钥 (所有人都知道) let public_h = g.modpow(&secret_x, &p); println!("--- 公开参数 ---"); println!("p = {}", p); println!("g = {}", g); println!("h = g^x mod p = {}", public_h); println!("-------------------"); // --- PROVER: 生成证明 --- println!("Prover 正在生成证明..."); let mut rng = thread_rng(); let order = &p - BigInt::one(); // 1. 承诺:随机选一个 k, 计算 t = g^k mod p let k = rng.gen_bigint_range(&BigInt::one(), &order); let t = g.modpow(&k, &p); // 2. 挑战 (Fiat-Shamir 的魔法在这里!): // 把公开信息和承诺 t 一起哈希,模拟一个无法预测的挑战 c let mut hasher = Sha256::new(); hasher.write_all(&g.to_bytes_be().1).unwrap(); hasher.write_all(&public_h.to_bytes_be().1).unwrap(); hasher.write_all(&t.to_bytes_be().1).unwrap(); let hash_bytes = hasher.finalize(); let c = BigInt::from_bytes_be(num_bigint::Sign::Plus, &hash_bytes) % ℴ // 3. 响应:计算 r = k - c*x (mod order) let cx = (&c * &secret_x) % ℴ let mut r = (&k - cx) % ℴ if r < BigInt::zero() { r += ℴ } println!("证明已生成:(r = {}, c = {})", r, c); println!("-------------------"); // --- VERIFIER: 验证证明 --- println!("Verifier 正在验证证明..."); // Verifier 为了验证,需要自己重新计算 t' = g^r * h^c mod p let gr = g.modpow(&r, &p); let hc = public_h.modpow(&c, &p); let t_prime = (&gr * &hc) % &p; // Verifier 再用算出来的 t' 计算 c' = H(g || h || t') let mut hasher = Sha256::new(); hasher.write_all(&g.to_bytes_be().1).unwrap(); hasher.write_all(&public_h.to_bytes_be().1).unwrap(); hasher.write_all(&t_prime.to_bytes_be().1).unwrap(); let hash_bytes = hasher.finalize(); let c_prime = BigInt::from_bytes_be(num_bigint::Sign::Plus, &hash_bytes) % ℴ if c == c_prime { println!("✅ 验证通过!"); } else { println!("❌ 验证失败!"); } } 以上我们通过最简单的代码来演示了 ZKP 的基本思想,从数学原理上都是基于离散对数困难性。
发散到 Passkeys
当我看到 Hash 的时候,我联想到了后台服务的密码存储,比如我们在做一个用户注册和登录功能的时候,为了安全我们是不会去存储用户的原始密码(秘密),而是会使用密码哈希方案,去存储 hash(password + salt)。
但这个密码哈希方案其实也泄露了“知识”,当你登录时会把 123456 发送给服务器,服务器计算 hash("123456" + salt) 并与数据库中的值对比。
- 在传输过程中:密码是明文的(当然可以用 TLS/SSL 加密,但服务器在解密后会看到明文)。
- 对服务器而言:服务器在验证那一瞬间是知道你的密码的。
- 如果数据库被盗:攻击者拿到了
hash(password + salt)的列表。这个哈希值本身就是一条重要的知识!它虽然不是密码原文,但它是密码的一个确定性指纹。攻击者可以进行:- 字典攻击:尝试常用密码,计算哈希值来一一比对。
- 彩虹表攻击:用一个预先计算好的哈希值数据库来反查。
- 暴力破解:对所有可能的组合进行哈希计算。
这就是为什么我们需要“加盐(salt)”和使用慢哈希函数(如 Argon2, bcrypt),目的就是为了增加攻击者进行上述离线攻击的成本,但无论如何,哈希值本身就是泄露的“知识”。
所以如果我们要更安全,一点“知识”都不泄露,似乎 ZKP 适合做认证服务?注册时不存密码哈希,只存公钥 h。登录时,我发送一个 ZKP 证明,服务器验证一下就行了,数据库被拖库了都没事。
甚至更简单点其实就用公私钥对不是更方便和安全么,Nostr 就是这么做的 (钱包也是这个原理),private key 是密码,每次发内容就用私钥签名内容,然后把 pubkey 带上,这样任何收到这条消息的节点都可以验证签名是否一致,这样就本质上通过各个 relay 节点形成一个去中心化的社交网络。
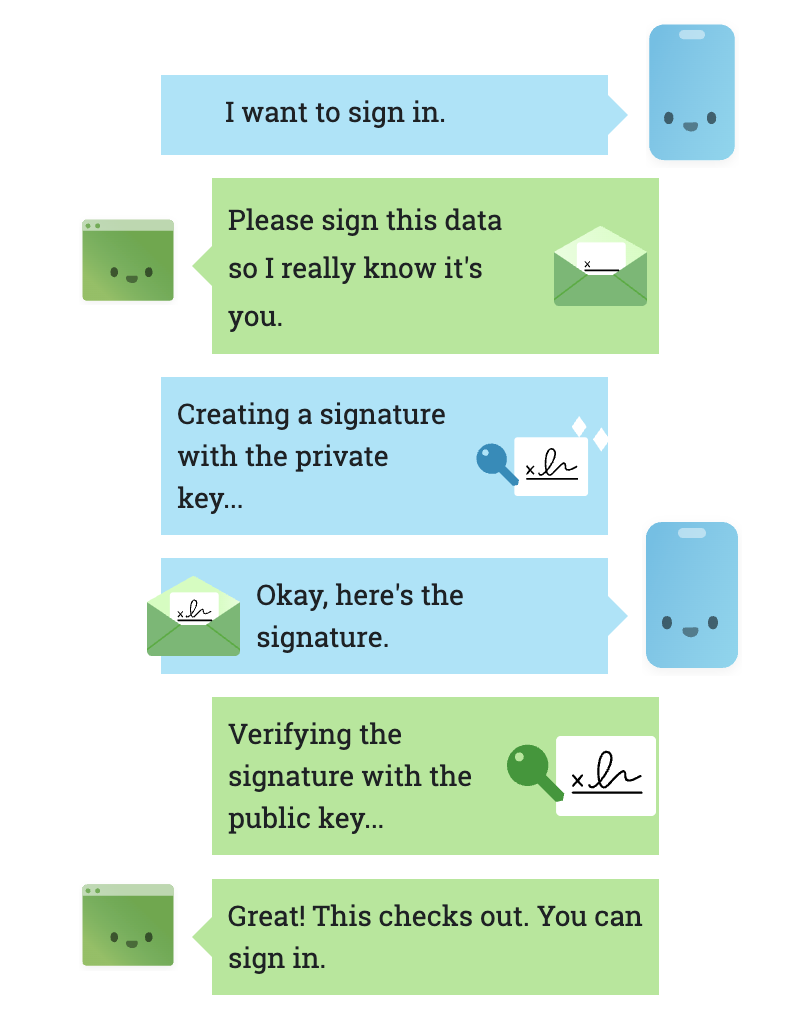
我按照这个思路去找 Web 相关的解决方案,业界给出的答案是 Passkeys (基于 WebAuthn 标准),使用非对称加密来替代密码(私钥不出设备),Passkeys 是这样工作的:
- 注册: 你的设备(如 iPhone 或 Android 手机)在本地生成一对密钥(私钥和公钥)。私钥安全地存储在设备的硬件安全芯片中,永远不会离开设备。你把公钥发送给网站服务器。
- 登录:
- 网站向你的设备发送一个“挑战”(一个随机数)。
- 你的设备用私钥对这个“挑战”进行签名,然后把签名发回给网站。
- 网站用它存储的你的公钥来验证这个签名是否有效。
- 用户体验: 整个过程对于用户来说,可能只是做一次指纹识别或面部识别来授权设备使用私钥。
2019 年 3 月 4 日 WebAuthn Level 1 已经被 W3C 正式发布为“推荐标准 (Recommendation)”,标志着它成为了一个成熟、稳定、官方推荐的 Web 标准。
通过“电路”证明程序的运行
从上面的例子我们看到,ZKP 很适合用来证明 Prover 知道某个秘密,比如一个数 x ,但 ZKP 的用途远不止于此,还可以证明任何计算过程的正确性。
为什么证明一个程序正确运行很重要,因为像以太坊这样的公链,如果所有的节点都运行同样的合约 (本质上就是一段程序代码) 多次,这无疑是很大的浪费,我们想通过 ZKP 把计算挪到链下,这样公链上的节点只需要验证程序被正确执行就可。
“我正确运行了一个复杂的程序,得到了这个输出。”—— 这要怎么证明?
答案是四个字:万物皆可电路 (Arithmetization)。
ZKP 系统(比如我们后面会聊的 zk-SNARKs)的“世界观”非常单纯,甚至有点笨拙,它看不懂我们人类写的高级代码,比如 if/else 语句、for 循环。
如果我们想让 ZKP 为我们工作,就必须先把我们要证明的东西,翻译成它唯一能听懂的语言。这个翻译过程,就是“算术化 (Arithmetization)”。而“电路”或“约束系统”,就是我们翻译出来的最终稿。这个重写的过程,就是“拍扁 (Flattening)”。你把一个有层次、有复杂逻辑的程序,变成了一个长长的、线性的、只包含最基本算术运算的指令列表。
任何程序,无论多复杂,都可以被“拍扁”成一系列最基础的加法和乘法约束。比如 out = x*x*x + x + 5 这段代码,可以被分解为:
v1 = x * xv2 = v1 * xv3 = v2 + xout = v3 + 5
于是,证明“我正确运行了程序”,就转化为了证明“我知道一组数 (x, v1, v2, ...



